Autoscaling
Auftrag
«Samstags um zehn geht es los», schreibt das Veloatelier Matte. «Unter der Woche kommt der Shop mit wenig aus. Am Samstag soll er wachsen, ohne dass jemand von euch daneben sitzt.»
Lernziele
Nach diesem Kapitel kannst du:
- Erklären, wie der HorizontalPodAutoscaler die Zahl der Pods berechnet
- Requests, Limits und Quotas für ein Deployment mit Autoscaling abstimmen
- Einen Lasttest durchführen und Wachsen und Schrumpfen beobachten
- Erkennen, wann mehr Pods nicht mehr helfen
- Autoscaling in Kubernetes mit der Elastizität von OneFlow vergleichen
Der HorizontalPodAutoscaler
Abschnitt betitelt „Der HorizontalPodAutoscaler“Der HorizontalPodAutoscaler (HPA) passt die Zahl der Pods eines Deployments an eine Metrik an, meist die CPU. Er vergleicht die mittlere Auslastung der Pods mit einem Ziel, gemessen in Prozent ihres CPU-Requests. Die Dokumentation von Kubernetes 1.36 gibt die Rechnung an.
gewünschte Pods = aufrunden(aktuelle Pods × aktuelle Auslastung / Ziel)Zwei Pods mit 120 % bei einem Ziel von 60 % ergeben vier Pods. Die Werte holt der HPA vom metrics-server, den k3s mitbringt.
# Two to six pods, a new pod when the pods use more than 60 % of their CPU request on averageapiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: webshopspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: webshop minReplicas: 2 maxReplicas: 6 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 60 behavior: # Shrink only after five calm minutes, so that the shop does not shrink between two waves of load scaleDown: stabilizationWindowSeconds: 300Der Webshop läuft mit zwei bis sechs Pods. Beim Schrumpfen wartet der HPA fünf Minuten und nimmt die höchste Empfehlung dieser Zeit. Ist der Shop zwischen zwei Wellen kurz ruhig, verliert er deshalb nicht gleich seine Pods. In Meilenstein 3 setzt du maxReplicas in webshop/hpa.yaml über Git auf die Obergrenze aus deinen persönlichen Werten.
Zwei Steuerungen für eine Zahl
Abschnitt betitelt „Zwei Steuerungen für eine Zahl“Bisher stand die Zahl der Pods in Git, die Zahl aus Kapitel 4.4. Mit dem HPA gäbe es zwei Steuerungen für dieselbe Zahl. Der HPA würde auf sechs erhöhen, Argo CD mit Self-Heal wieder auf drei zurücksetzen, immer im Wechsel. Das Deployment in observability/repo/webshop hat darum kein replicas mehr. Fehlt das Feld in Git, rührt Argo CD es nicht an. Die Zahl bestimmt dann allein der HPA. Beim Wechsel fiel das Deployment im Lab für etwa 15 Sekunden auf einen Pod, bis der HPA es wieder auf sein Minimum hob.
apiVersion: apps/v1kind: Deploymentmetadata: name: webshop labels: app: webshopspec: # No replicas here, the HorizontalPodAutoscaler sets them. A value in Git would fight with it selector: matchLabels: app: webshop template: metadata: labels: app: webshop spec: securityContext: runAsNonRoot: true containers: - name: webshop image: ghcr.io/ndum/cc/webshop:1.0.0 imagePullPolicy: IfNotPresent ports: - name: http containerPort: 8080 env: - name: SHOP_NAME value: Veloatelier Matte # Work per request in milliseconds, makes the load test visible in the CPU - name: WORK_MS value: "20" # Share of requests answered with an error, raise it to break the SLO on purpose - name: FAIL_PERCENT value: "0" resources: requests: cpu: 50m memory: 64Mi # 6 pods with 250m stay below the quota of 2 CPU with room for the pods of a rollout limits: cpu: 250m memory: 128Mi readinessProbe: httpGet: path: /healthz port: http timeoutSeconds: 3 livenessProbe: httpGet: path: /healthz port: http # A busy pod may need longer than the default second, a failed liveness check restarts it timeoutSeconds: 3WORK_MS lässt den Shop pro Anfrage 20 Millisekunden rechnen, damit die Last in der CPU sichtbar wird. Der Request von 50m ist die Grundlage der Prozente des HPA, das Limit von 250m die Obergrenze eines Pods.
Der Lasttest
Abschnitt betitelt „Der Lasttest“Das Image des Webshops enthält einen Lastgenerator, load.py. Er schickt mit mehreren Threads Anfragen, so schnell der Shop antwortet. Alle zehn Sekunden gibt er Durchsatz, Fehler und Antwortzeit aus. Du startest ihn als Pod im Namespace default und schickst die Last über Traefik, auf dem Weg, den auch die Kundschaft nimmt.
kubectl run load --restart=Never --image=ghcr.io/ndum/cc/webshop:1.0.0 -- \ python3 /app/load.py http://<adresse-des-servers>/ --workers 20 --seconds 240kubectl -n velo get hpa webshop --watchkubectl logs load--watch läuft weiter, bis du es mit Ctrl+C beendest. Die Ausgabe des Generators siehst du danach mit kubectl logs load, oder du öffnest dafür ein zweites Terminal. Der beendete Pod load bleibt stehen. Vor einem weiteren Lauf löschst du ihn mit kubectl delete pod load, sonst meldet kubectl run, dass es ihn schon gibt.
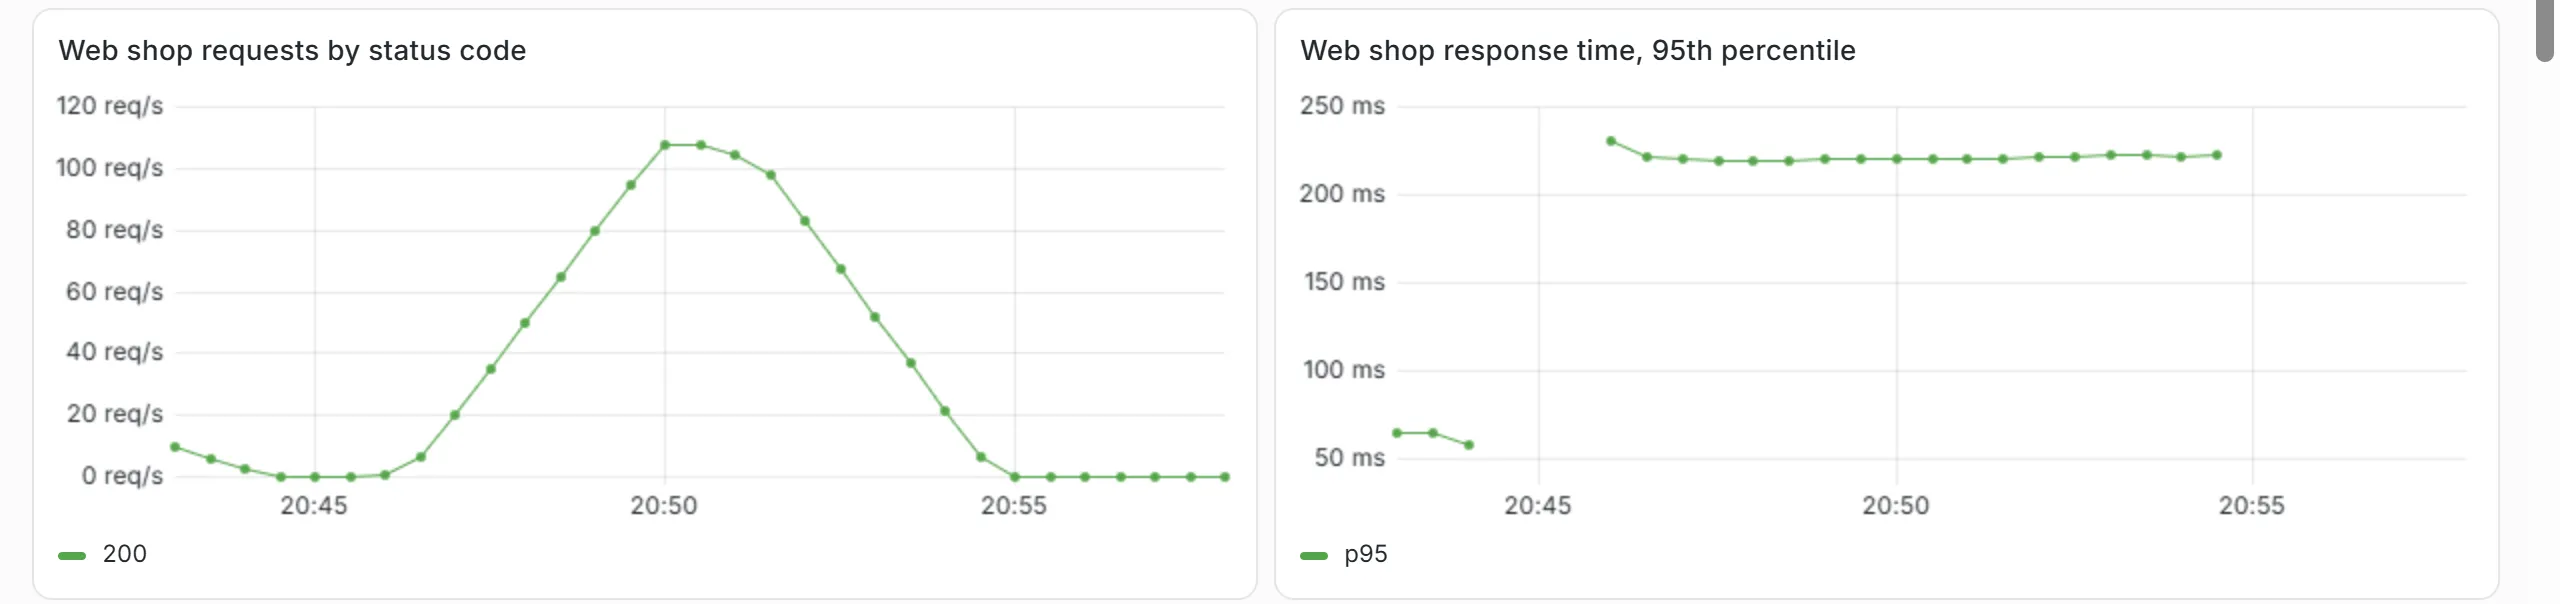
Im Lab stand der HPA nach knapp 30 Sekunden bei über 400 % und verlangte sechs Pods. Gut 40 Sekunden nach dem Start liefen sechs Pods mit je 500 % ihres Requests, also am Limit von 250m. Mit zwei Pods meldete der Generator knapp 60 Anfragen pro Sekunde, 95 % davon kamen in 1,3 s zurück. Mit sechs Pods waren es rund 145 Anfragen pro Sekunde in knapp 300 ms. Nach dem Ende der Last blieb der Shop wegen der Wartezeit von fünf Minuten zuerst bei sechs Pods. Gut fünf Minuten nach dem Ende schrumpfte er auf vier Pods, 15 Sekunden später auf zwei. Jeder überzählige Pod war nach zwei Sekunden beendet, denn der Webshop antwortet nach dem Signal zum Beenden noch zwei Sekunden und stoppt dann.
Im Dashboard aus Kapitel 5.1 sieht der Lasttest so aus.
Grenzen
Abschnitt betitelt „Grenzen“Im Lab zeigten sich drei Grenzen, die im Betrieb ebenso vorkommen.
Die Quota
Abschnitt betitelt „Die Quota“In einem ersten Versuch hatte jeder Pod ein Limit von 500m. Die Quota des Veloateliers erlaubt 2 CPU an Limits. Der HPA wollte sechs Pods, es liefen vier, der fünfte scheiterte mit dieser Meldung.
Error creating: pods "webshop-68674cff94-7ln2v" is forbidden: exceeded quota: member, requested: limits.cpu=500m, used: limits.cpu=2, limited: limits.cpu=2Die Quota aus Kapitel 4.5 schützt die anderen Mitglieder, sie begrenzt aber auch das Wachsen. Wer maxReplicas setzt, rechnet nach, ob maxReplicas × Limit in die Quota passt.
Der Rollout
Abschnitt betitelt „Der Rollout“Bei sechs Pods am Limit der Quota änderte jemand eine Variable des Deployments. Kubernetes startet bei einem Rollout zusätzliche Pods, bevor es alle alten beendet, in der Standardeinstellung bis zu 25 % mehr. Für diese Pods war in der Quota kein Platz, der Rollout blieb mit zwei neuen und drei alten Pods stehen. Eine Quota braucht darum Reserve für die zusätzlichen Pods eines Rollouts. Mit 250m passen sechs Pods und zwei zusätzliche Pods in 2 CPU.
Der Engpass anderswo
Abschnitt betitelt „Der Engpass anderswo“Als die Quota im ersten Versuch erhöht wurde, liefen sechs statt vier Pods, der Durchsatz stieg aber nur von 175 auf 185 Anfragen pro Sekunde. Der Lastgenerator ist ein einzelner Python-Prozess und schafft nicht mehr. Mehr Pods helfen nur, wenn der Shop der Engpass ist. Bevor du skalierst, klärst du deshalb, wo die Zeit verloren geht.
Vergleich mit OneFlow
Abschnitt betitelt „Vergleich mit OneFlow“| OneFlow, Kapitel 3.5 | HPA | |
|---|---|---|
| Einheit | VM | Pod |
| Start einer neuen Einheit | Minuten | Sekunden |
| Messung | CPU aus der Überwachung von OpenNebula | CPU des metrics-servers |
| Wachsen im Lab | nach etwa 155 Sekunden | nach etwa 40 Sekunden |
| Grenze | max_vms und Quota der Gruppe | maxReplicas und ResourceQuota |
| Zeitplan | scheduled_policies mit Cron | nicht im HPA, etwa mit einem CronJob, der minReplicas ändert |
Container starten schneller als VMs, darum reagiert der HPA früher als OneFlow. In beiden Systemen misst eine Regel, vergleicht mit einem Ziel und ändert die Zahl innerhalb fester Grenzen. Beide laufen auf derselben Hardware. Sechs Pods helfen nur, wenn die zwei VMs des Clusters genug CPU haben.
Der Check von Teil 5
Abschnitt betitelt „Der Check von Teil 5“Der Check dieses Teils prüft die Exporter von OpenNebula und Libvirt sowie die Applications monitoring, monitoring-config, loki und alloy in Argo CD. Dazu kommen die Jobs opennebula, opennebula-libvirt und webshop in Prometheus, die Regeln des SLO, Alertmanager mit seiner Konfiguration, die Logs des Veloateliers in Loki und der HPA des Webshops. Für die Abfrage in Loki liest er das Passwort von Grafana aus ~/cc-lab/grafana.pass. Starte ihn auf dem Front-end, sobald Prometheus alle Ziele als up zeigt.
python3 ~/cc/checks/check.py observabilityDie Zeile zu einem eigenen Empfänger in Alertmanager mit [+!!] gehört zum Zusatzauftrag B in Kapitel 5.5 und zählt nicht zur Basis.
Aufgabe Lab
Prüfe mit kubectl -n velo get hpa webshop, dass der HPA läuft, der mit den Ergänzungen aus Kapitel 5.1 in dein Repo kam. Führe den Lasttest durch und notiere, wann der Shop wächst und wann er schrumpft. Zeige im Dashboard aus Kapitel 5.1, wie sich Verkehr und Antwortzeit verhalten. Lass zum Schluss den Check observability laufen und lade seinen Bericht in dein Abgabe-Repo.
Lösung
kubectl -n velo get hpa webshop --watch zeigt die Auslastung steigen und die Pods von zwei auf sechs wachsen, im Lab innerhalb einer Minute. Im Dashboard steigen die Anfragen pro Sekunde und auch die Antwortzeit. Sie blieb im Lab aber unter der Grenze von 0,5 s aus Kapitel 5.3. Nach dem Ende bleibt der Shop fünf Minuten bei sechs Pods und fällt dann auf zwei. Der Check endet mit «15 von 15 Prüfungen der Basis erfüllt» und «0 von 1 Prüfungen der Zusatzaufträge erfüllt».
Aufgabe Quota und HPA
Das Veloatelier will am Samstag bis zu zehn Pods. Was musst du im Repo ändern? Was prüfst du, bevor du den Pull Request annimmst?
Lösung
maxReplicas: 10 in webshop/hpa.yaml und in members/velo eine höhere Quota für limits.cpu. Zehn Pods mit 250m brauchen 2,5 CPU, mit Reserve für den Rollout eher 3. Vor dem Annehmen prüfst du, ob die zwei VMs die Requests tragen und ob die Summe der Quotas aller Mitglieder noch vertretbar ist, wie in Kapitel 4.5.
Aufgabe Samstag um zehn
Das Veloatelier weiss, dass die Last samstags um zehn beginnt. Wie bereitest du den Shop vor, damit er nicht erst bei der ersten Welle wächst?
Lösung
Ein CronJob, der samstags um 9.45 Uhr minReplicas des HPA auf vier setzt und am Abend zurück, wirkt wie die Regel nach Zeitplan in OneFlow. Weil das Repo die Quelle ist, gehört die Änderung entweder als geplanter Commit nach Git, oder minReplicas wird in Argo CD vom Vergleich mit Git ausgenommen. Sonst setzt Self-Heal den Wert gleich wieder zurück.
Texte und Abbildungen stehen unter CC BY-SA 4.0 und der Code unter der MIT-Lizenz. Die Quellen liegen auf GitHub.