Alerts und SLOs
Auftrag
«Wir wollen nicht bei jedem kleinen Fehler geweckt werden», schreibt das Veloatelier Matte. «Aber wenn der Shop am Samstag nicht verkauft, wollen wir es wissen, bevor die Kundschaft anruft.»
Lernziele
Nach diesem Kapitel kannst du:
- SLI, SLO, SLA und Fehlerbudget unterscheiden
- Ein SLO für den Webshop formulieren und sein Fehlerbudget berechnen
- Einen Alert nach Burn Rate lesen und begründen
- Alerts auf Symptome von Alerts auf Ursachen unterscheiden
- Erklären, wie Alertmanager Alerts gruppiert und weiterleitet
SLI, SLO und SLA
Abschnitt betitelt „SLI, SLO und SLA“Ein Service Level Indicator (SLI) misst, wie gut ein Dienst aus Sicht der Kundschaft arbeitet, meist als Anteil guter Ereignisse. Das Ziel für diesen Anteil über einen Zeitraum heisst Service Level Objective (SLO). Ein Service Level Agreement (SLA) ist ein Vertrag, der Folgen festlegt, wenn das Ziel verfehlt wird. SLAs kommen in Teil 6, dieses Kapitel bleibt beim internen Ziel.
| Begriff | Webshop |
|---|---|
| SLI | Anteil der Anfragen an den Shop, die ohne Serverfehler beantwortet werden |
| SLO | 99,5 % über 7 Tage |
| Fehlerbudget | 0,5 % der Anfragen dürfen scheitern |
Kein Dienst erreicht 100 %. Das Fehlerbudget legt fest, wie viele Fehler im Zeitraum erlaubt sind. Mit dieser Zahl lässt sich planen. Solange Budget übrig ist, darf das Veloatelier Neues ausprobieren. Ist es aufgebraucht, haben Stabilität und Korrekturen Vorrang.
Recording Rules
Abschnitt betitelt „Recording Rules“Die Regeln liegen in deinem Repo unter monitoring/config/webshop-slo.yaml, als PrometheusRule.
# Service level of the web shop and its alerts, chapter 5.3## SLO: 99.5 % of the requests to the shop are answered without a server error, measured over 7 days.# The error budget is 0.5 % of the requests. The burn rate says how many times faster than allowed# the budget is used up, at 14.4 a 7-day budget would be gone in about 12 hours.apiVersion: monitoring.coreos.com/v1kind: PrometheusRulemetadata:  name: webshop-slospec:  groups:    - name: webshop-slo      rules:        # Recording rules compute the error ratio once, alerts and dashboards reuse it        - record: webshop:error_ratio:rate5m          expr: |            sum(rate(webshop_requests_total{code=~"5.."}[5m]))            / clamp_min(sum(rate(webshop_requests_total[5m])), 0.001)        - record: webshop:error_ratio:rate1h          expr: |            sum(rate(webshop_requests_total{code=~"5.."}[1h]))            / clamp_min(sum(rate(webshop_requests_total[1h])), 0.001)
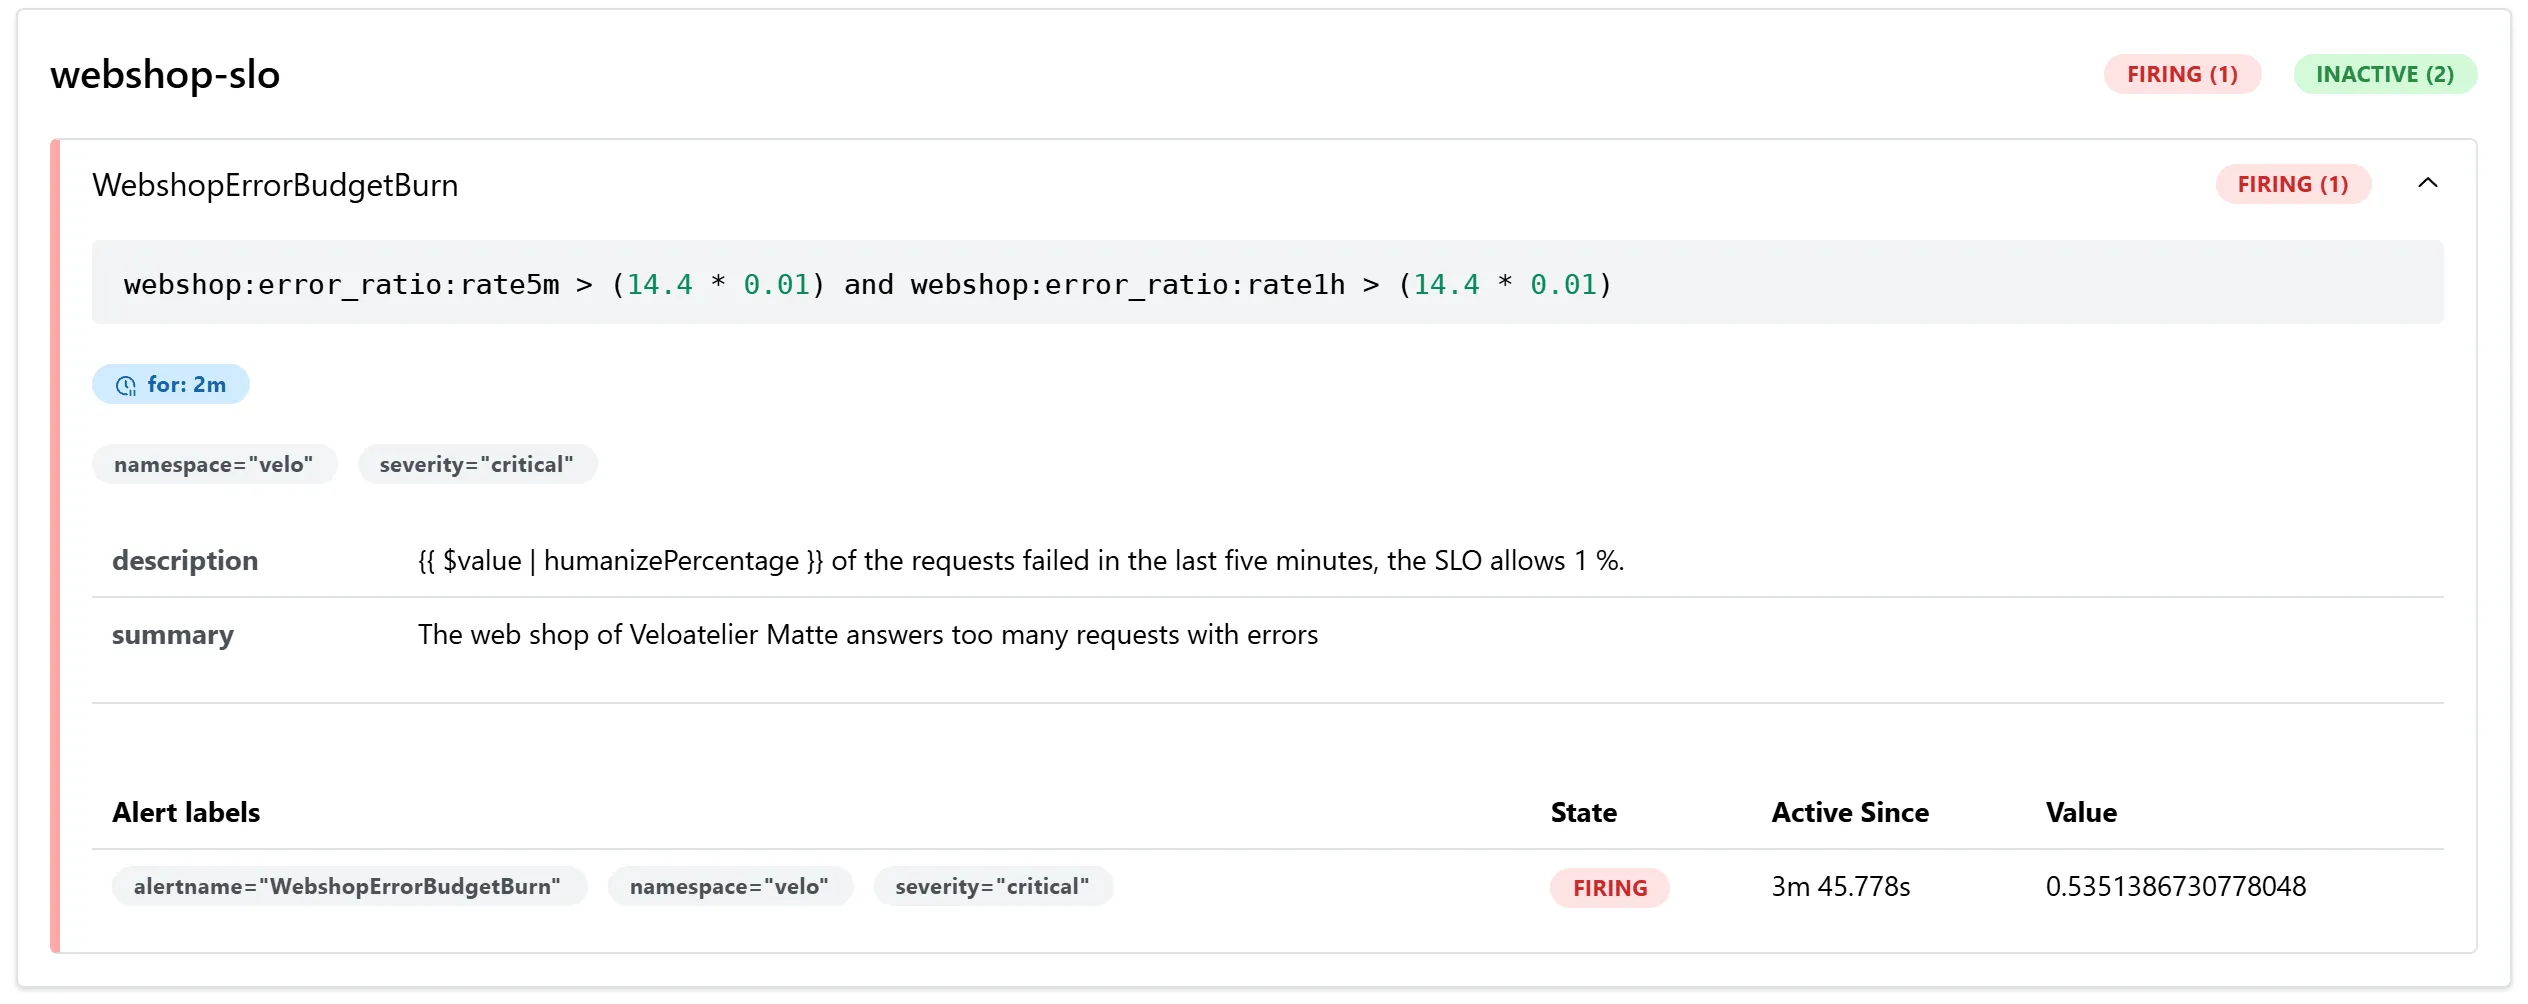
        # Symptom, the customers get errors and the budget burns fast. Both windows must agree,        # the short one ends the alert quickly once the cause is gone        - alert: WebshopErrorBudgetBurn          expr: |            webshop:error_ratio:rate5m > (14.4 * 0.005)            and            webshop:error_ratio:rate1h > (14.4 * 0.005)          for: 2m          labels:            severity: critical            namespace: velo          annotations:            summary: The web shop of Veloatelier Matte answers too many requests with errors            description: '{{ $value | humanizePercentage }} of the requests failed in the last five minutes, the SLO allows 0.5 %.'
        # Symptom, the customers wait        - alert: WebshopSlow          expr: |            histogram_quantile(0.95, sum by (le) (rate(webshop_request_duration_seconds_bucket[5m]))) > 0.5          for: 5m          labels:            severity: warning            namespace: velo          annotations:            summary: The web shop answers slowly            description: 95 % of the requests took up to {{ $value | humanizeDuration }}, the goal is 0.5 s.
        # Symptom, nothing answers at all        - alert: WebshopDown          expr: sum(up{job="webshop"}) == 0 or absent(up{job="webshop"})          for: 1m          labels:            severity: critical            namespace: velo          annotations:            summary: No pod of the web shop answers Prometheus            description: Prometheus reaches none of the web shop pods.
Die ersten zwei Regeln sind Recording Rules. Prometheus berechnet den Fehleranteil über fünf Minuten und über eine Stunde regelmässig und speichert beide als eigene Zeitreihen. Sie heissen webshop:error_ratio:rate5m und webshop:error_ratio:rate1h. Alerts und Dashboards lesen diese Reihen, statt dieselbe Rechnung jedes Mal neu zu machen. clamp_min verhindert eine Division durch null, wenn gerade niemand einkauft.
Burn Rate
Abschnitt betitelt „Burn Rate“Ein Alert auf «mehr als 0,5 % Fehler» würde bei jeder kurzen Spitze auslösen. Die Burn Rate gibt an, wie schnell das Budget verbraucht wird. Eine Burn Rate von 1 braucht es genau in den 7 Tagen auf, bei 14,4 wäre es nach 168 / 14,4 ≈ 12 Stunden weg. Der Alert WebshopErrorBudgetBurn löst aus, wenn beide Fehleranteile über 14,4 × 0,5 % = 7,2 % liegen, der über fünf Minuten wie der über eine Stunde. Das muss zwei Minuten lang so bleiben. Diese Wartezeit legt das Feld for der Alerting Rule fest.
In Meilenstein 3 gilt das Ziel aus deinen persönlichen Werten. Das Fehlerbudget ist dann 1 minus dein Ziel, bei 99,0 % also 1 %. Du ersetzt 0.005 in beiden Zeilen des Alerts durch dein Budget. Mit 1 % liegt die Schwelle bei 14,4 × 1 % = 14,4 %.
| Fenster | Aufgabe |
|---|---|
| 1 Stunde | zeigt, dass das Problem anhält und das Budget wirklich angreift |
| 5 Minuten | zeigt, ob es jetzt noch besteht. Nach der Behebung endet der Alert darum bald |
Im Lab war die Wirkung des langen Fensters gut zu sehen. Ein Lasttest hatte vorher zehntausende gute Anfragen erzeugt. Als danach jede achte Anfrage scheiterte, lag der Anteil über fünf Minuten sofort bei 12 %, der über eine Stunde aber lange bei 3 bis 4 %. Der Alert löste erst nach rund 25 Minuten aus, nachdem der Fehleranteil weiter gestiegen war.
Symptome und Ursachen
Abschnitt betitelt „Symptome und Ursachen“Die drei Alerts des Webshops melden Symptome, also das, was die Kundschaft merkt. Neben WebshopErrorBudgetBurn sind das WebshopSlow und WebshopDown. Ursachen wie eine volle Disk, ein Pod in einer Neustartschleife oder ein Knoten ohne Speicher bringt kube-prometheus-stack als eigene Regeln mit, etwa KubePodCrashLooping oder KubePersistentVolumeFillingUp. Im Lab meldete Prometheus KubePersistentVolumeFillingUp, als die Disk des Agents nach dem Download des Images von Ollama für die Zusatzaufträge zu 87 % voll war. Die Volumes von local-path liegen auf derselben Disk wie die Images.
Für Symptome darf man Menschen wecken, denn sie betreffen die Kundschaft sicher. Ursachen gehören in Tickets und Dashboards. Ein Alert, auf den niemand reagieren muss, gehört gelöscht, sonst lernt das Team, Alerts zu übersehen.
Alertmanager
Abschnitt betitelt „Alertmanager“Prometheus wertet die Regeln aus und schickt auslösende Alerts an Alertmanager. Alertmanager fasst ähnliche Alerts zusammen, unterdrückt Wiederholungen und leitet sie an Empfänger weiter, etwa per E-Mail, in einen Chat oder an einen Webhook. Die Weiterleitung steht in den Werten von kube-prometheus-stack, ihre Felder beschreibt die Konfiguration von Alertmanager 0.34.
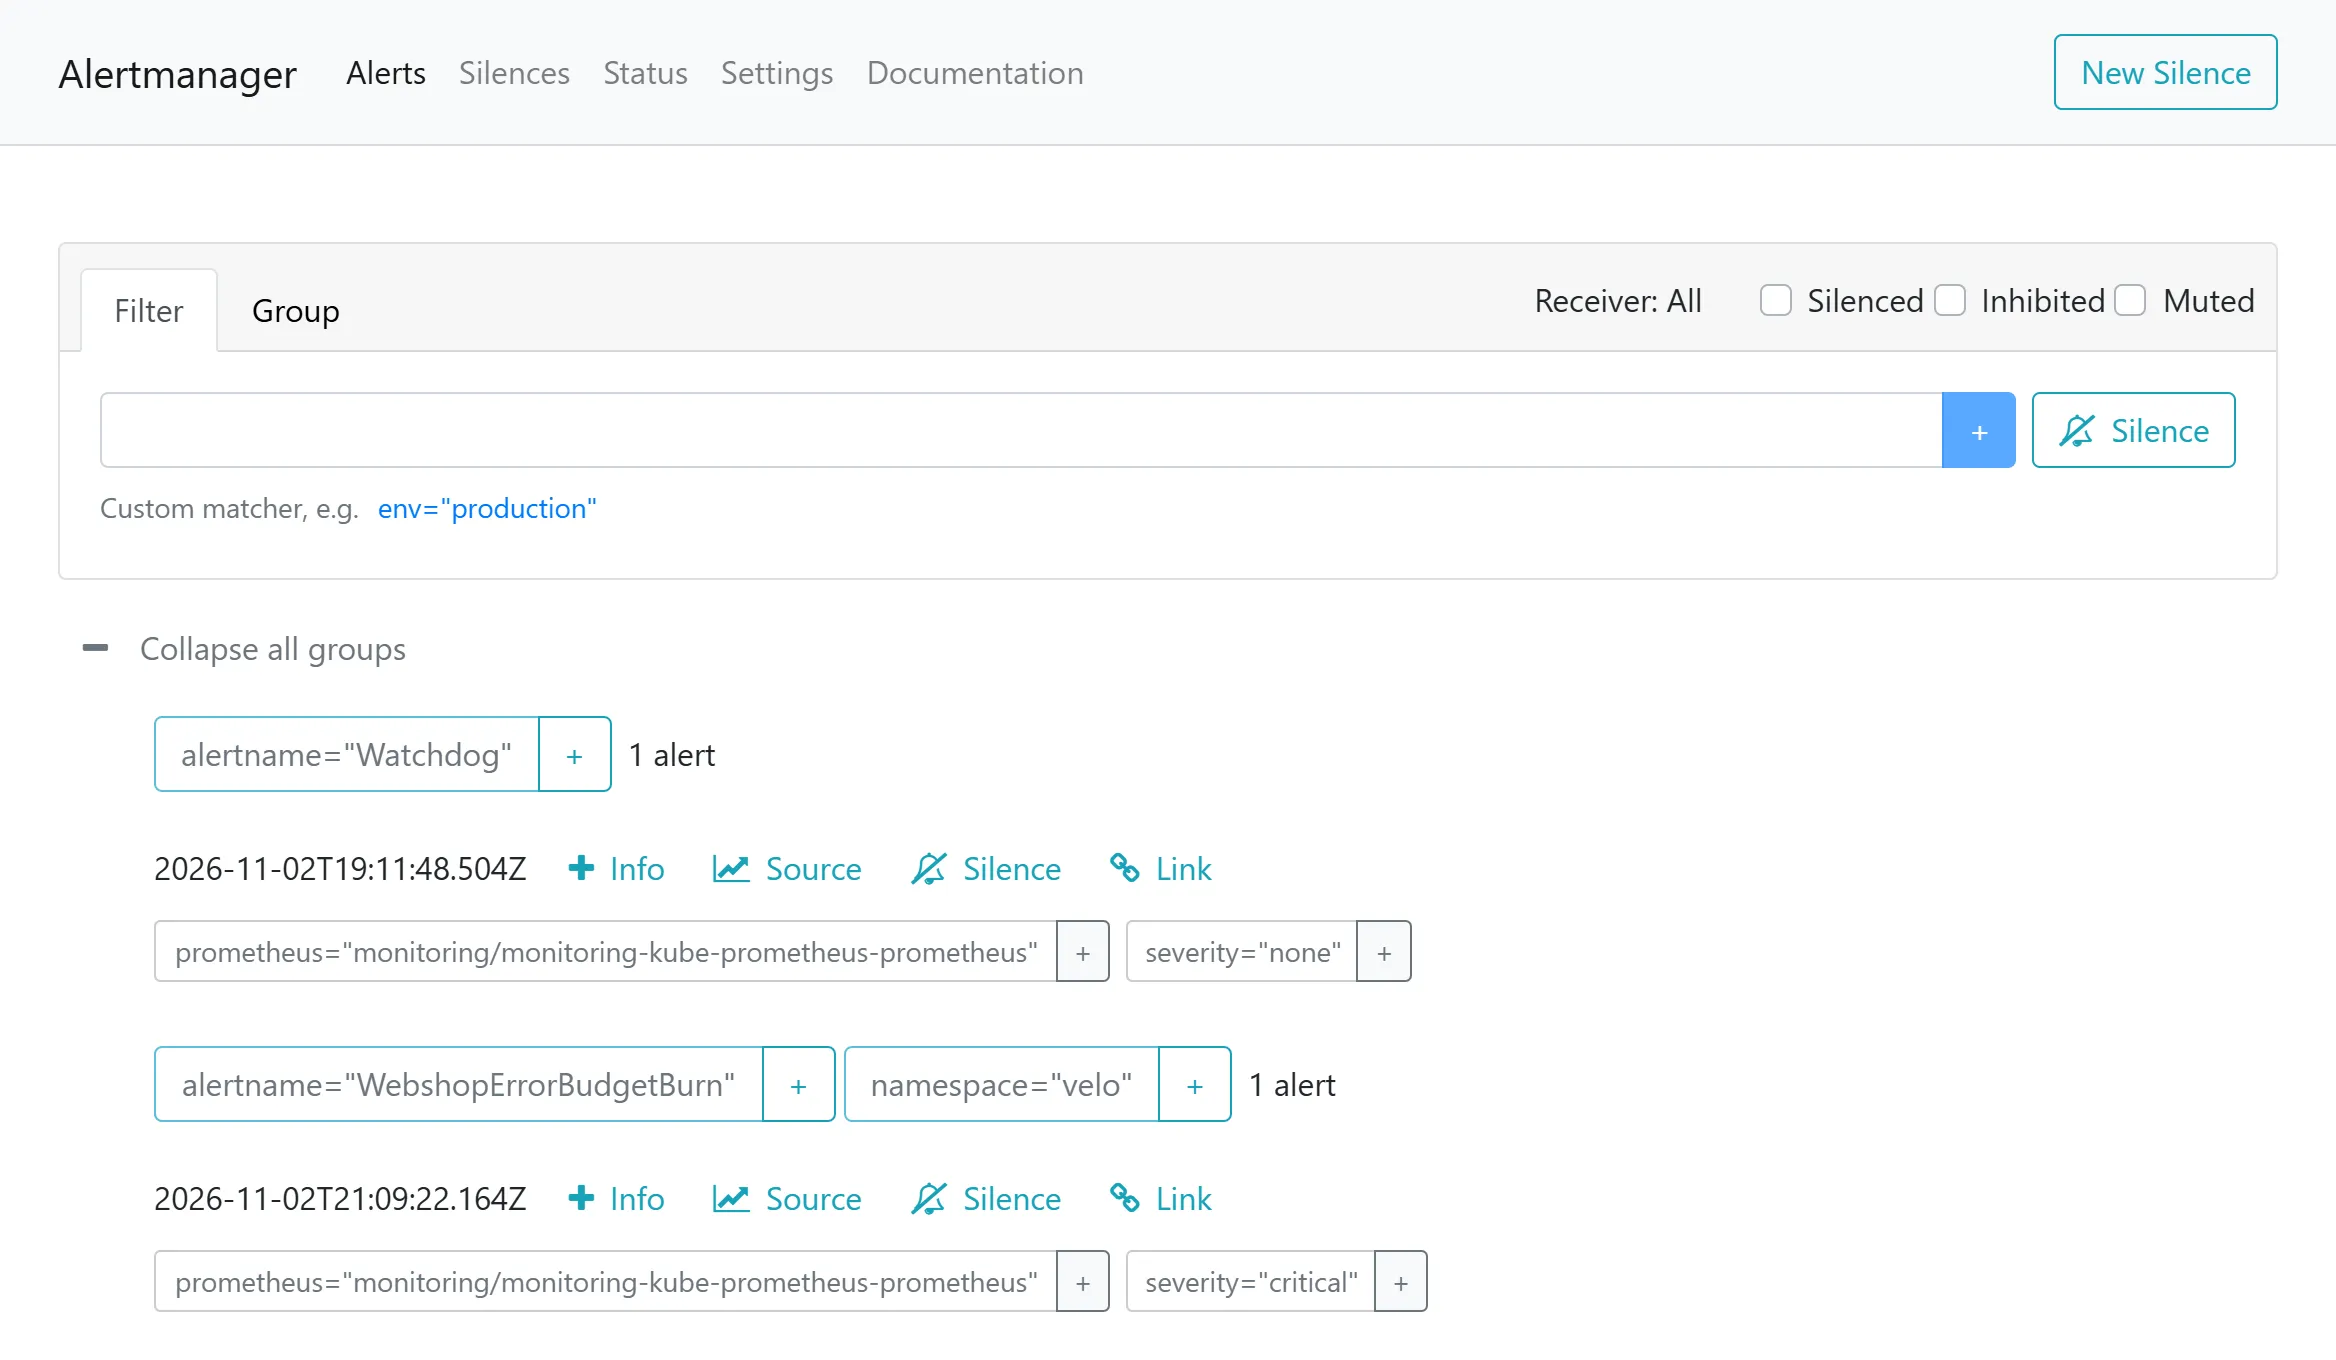
route: receiver: "null" group_by: [alertname, namespace] group_wait: 30s group_interval: 5m repeat_interval: 4hreceivers: - name: "null"In der Basis gehen alle Alerts an den Empfänger null, der nichts verschickt. Sie erscheinen nur in der Oberfläche von Alertmanager auf Port 30093 des Servers. Die Oberfläche erreichst du wie Prometheus über einen Tunnel. Ergänze dazu den Befehl aus Kapitel 5.1 um -L 9093:<adresse-des-servers>:30093 und öffne im Browser des Clients http://localhost:9093/. Einen eigenen Empfänger mit einer Route richtest du in Zusatzauftrag B aus Kapitel 5.5 ein. group_wait wartet 30 Sekunden auf weitere Alerts derselben Gruppe, repeat_interval wiederholt einen offenen Alert erst nach vier Stunden.
Einen Alert auslösen
Abschnitt betitelt „Einen Alert auslösen“Du brichst das SLO absichtlich über Git. Der Webshop hat dafür die Variable FAIL_PERCENT, sie gibt an, wie viel Prozent der Anfragen er mit einem Fehler beantwortet.
cd ~/platformsed -i '/FAIL_PERCENT/{n;s/value: "0"/value: "60"/}' webshop/deployment.yamlgit commit -am "Neues Zahlungsmodul im Webshop"git pushkubectl run load --restart=Never --image=ghcr.io/ndum/cc/webshop:1.0.0 -- \ python3 /app/load.py http://<adresse-des-servers>/ --workers 1 --seconds 1800In Prometheus unter «Alerts» wechselt WebshopErrorBudgetBurn zuerst auf pending und nach zwei Minuten auf firing. Die Last lässt nebenbei den Webshop über den HPA aus Kapitel 5.4 wachsen. Danach stellst du mit git revert und git push den alten Stand wieder her. Den Pod load löschst du erst, wenn der Alert inaktiv ist. Ohne Verkehr bliebe der Anteil im Fenster von fünf Minuten stehen und fiele erst, wenn das Fenster leer ist. Im Lab war der Alert sechs bis sieben Minuten nach dem Revert wieder inaktiv. Bis zu zwei Minuten davon vergingen, bis Argo CD den Revert ausrollte.
Aufgabe Lab
Löse den Alert wie oben aus, beobachte ihn in Prometheus und Alertmanager und stelle den alten Stand wieder her. Notiere die Zeiten.
Lösung
Nach dem Push steigt webshop:error_ratio:rate5m innerhalb weniger Minuten über 7,2 %. Wie lange webshop:error_ratio:rate1h braucht, hängt vom Verkehr der letzten Stunde ab. Ohne vorherigen Lasttest geht es schneller. Alertmanager zeigt den Alert in seiner Oberfläche. Nach dem Revert fällt der Anteil über fünf Minuten. Der Alert endet, obwohl der Anteil über eine Stunde noch hoch ist.
Aufgabe Fehlerbudget
Der Webshop beantwortet an einem Samstag 40’000 Anfragen. Wie viele dürfen scheitern, bis das Budget dieses Tages verbraucht ist? Was heisst eine Burn Rate von 6 für das Budget der Woche?
Lösung
0,5 % von 40’000 sind 200 Anfragen. Eine Burn Rate von 6 verbraucht das Budget sechsmal so schnell wie erlaubt, das Budget von 7 Tagen wäre nach 28 Stunden weg. Ein zweiter Alert mit tieferer Schwelle und längeren Fenstern würde so etwas melden, ohne gleich jemanden zu wecken.
Aufgabe Für die Praxis
Die Praxis Rosenweg will einen Alert, bevor Patientinnen und Patienten etwas merken. Schlage ein SLI und ein SLO für ihr Terminportal vor und begründe die Werte.
Lösung
Ein mögliches SLI ist der Anteil der Aufrufe der Terminseite, die ohne Fehler in weniger als einer Sekunde antworten. Ein SLO von 99,9 % über 30 Tage erlaubt etwa 43 Minuten Ausfall im Monat. Die Praxis hat Sprechzeiten, darum könnte man nur Anfragen zwischen 7 und 19 Uhr zählen. Höhere Ziele kosten Redundanz, die ein Lab mit einem Server nicht hat.
Texte und Abbildungen stehen unter CC BY-SA 4.0 und der Code unter der MIT-Lizenz. Die Quellen liegen auf GitHub.