Metriken mit Prometheus
Auftrag
«Es ist Frühling. Der Webshop des Veloateliers wird jeden Samstag langsamer», schreibt Simone Wyss. «Die Praxis Rosenweg will wissen, ob die Plattform läuft, bevor Patientinnen anrufen. Und ich will sehen, ob unsere Knoten noch Platz haben.»
Lernziele
Nach diesem Kapitel kannst du:
- Die vier goldenen Signale nennen und erklären, was Überwachung leisten soll
- Das Modell von Prometheus mit Zeitreihen, Labels, Exportern und dem Abholen erklären
- Den Monitoring-Stack über Argo CD aus deinem Plattform-Repo ausrollen
- OpenNebula und den Webshop als Ziele einbinden
- Einfache Abfragen mit PromQL schreiben und in Grafana darstellen
Der Zweck der Überwachung
Abschnitt betitelt „Der Zweck der Überwachung“Überwachung soll zeigen, was kaputt ist und warum. Dass etwas nicht stimmt, merkt oft auch die Kundschaft, etwa an einem langsamen Shop. Den Grund findest du erst im System selbst, zum Beispiel volle Disks oder einen Knoten ohne freien Speicher. Das Buch «Site Reliability Engineering» von Google nennt vier goldene Signale, die man für jeden Dienst messen sollte.
| Signal | Frage | Beim Webshop |
|---|---|---|
| Latenz | Wie lange dauert eine Antwort? | Antwortzeit von / |
| Verkehr | Wie viel wird verlangt? | Anfragen pro Sekunde |
| Fehler | Wie viel geht schief? | Anteil der Antworten mit 5xx |
| Sättigung | Wie voll ist das System? | CPU der Pods, Speicher der Knoten |
Prometheus
Abschnitt betitelt „Prometheus“Prometheus speichert Zeitreihen. Eine Zeitreihe ist ein Name mit Labels und einer Folge von Werten mit Zeitstempel.
webshop_requests_total{code="200", path="/", pod="webshop-599c7b4f94-4htg9"} 1532Prometheus holt die Werte selbst ab, in der Regel alle 15 bis 30 Sekunden. Jedes Ziel bietet unter /metrics eine Textseite an. Programme, die das nicht selbst können, bekommen einen Exporter, ein kleines Programm, das Werte sammelt und im Format von Prometheus ausgibt. Der Webshop aus Kapitel 4.4 hat /metrics schon eingebaut.
| Typ | Bedeutung | Beispiel |
|---|---|---|
| Counter | zählt nur aufwärts, bis zum Neustart | webshop_requests_total |
| Gauge | kann steigen und sinken | opennebula_host_mem_usage_bytes |
| Histogram | zählt Werte in Klassen, für Perzentile | webshop_request_duration_seconds_bucket |
Der Stack
Abschnitt betitelt „Der Stack“kube-prometheus-stack ist ein Helm-Chart der Community von Prometheus. Es bringt Prometheus, Alertmanager, Grafana, den Prometheus Operator, kube-state-metrics für den Zustand der Objekte im Cluster und node-exporter für die Nodes mit. Der Operator führt eigene Ressourcentypen ein. Ein ServiceMonitor sagt, bei welchen Services Prometheus Metriken abholt, eine ScrapeConfig nennt Ziele ausserhalb des Clusters, eine PrometheusRule enthält Regeln.
Der Stack kommt wie der Webshop aus Git. Die Ergänzungen für Teil 5 liegen im Kursrepo unter platform/observability/repo. Du kopierst sie über dein Plattform-Repo und ersetzt die Platzhalter durch deine Adressen.
source /etc/cc-lab.envcd ~/platformcp -r ~/cc/platform/observability/repo/. .sed -i "s#http://FRONTEND:3000#http://$CC_FE_IP:3000#" apps/*.yamlsed -i "s/FRONTEND_IP/$CC_FE_IP/; s/NODE1_IP/$CC_NODE1_IP/; s/NODE2_IP/$CC_NODE2_IP/" monitoring/config/opennebula.yamlgit statusgit status zeigt neue Applications in apps, den Ordner monitoring und geänderte Dateien in webshop und templates/member. Bevor du pushst, legst du das Passwort für Grafana als Secret an, damit es nicht in Git landet.
#!/bin/bash# Creates the secrets of the monitoring stack that do not belong in Git, chapter 5.1.##   ~/cc/platform/observability/make-secrets.sh## The Grafana password is stored in ~/cc-lab/grafana.pass.set -euo pipefail
pass_file=~/cc-lab/grafana.passif [ ! -f "$pass_file" ]; then install -m 0600 /dev/null "$pass_file" openssl rand -hex 12 > "$pass_file"fikubectl create namespace monitoring --dry-run=client -o yaml | kubectl apply -f -kubectl -n monitoring create secret generic grafana-admin \ --from-literal=admin-user=admin \ --from-literal=admin-password="$(tr -d '\n' < "$pass_file")" \ --dry-run=client -o yaml | kubectl apply -f -echo "Grafana user admin, password in $pass_file"~/cc/platform/observability/make-secrets.shDie Application monitoring holt das Chart aus dem Repo der Community und die Werte aus deinem Gitea. Argo CD kann dafür mehrere Quellen in einer Application verbinden.
# Prometheus, Alertmanager and Grafana from the chart kube-prometheus-stack, the values come from this repoapiVersion: argoproj.io/v1alpha1kind: Applicationmetadata: name: monitoring namespace: argocdspec: project: default sources: - repoURL: https://prometheus-community.github.io/helm-charts chart: kube-prometheus-stack targetRevision: 92.17.0 helm: releaseName: monitoring valueFiles: - $values/monitoring/kube-prometheus-stack.yaml - repoURL: http://FRONTEND:3000/wolkenwerk/platform.git targetRevision: main ref: values destination: server: https://kubernetes.default.svc namespace: monitoring syncPolicy: automated: prune: true selfHeal: true syncOptions: - CreateNamespace=true # The definitions of the operator are too large for the annotation of a client-side apply - ServerSideApply=true# Values of kube-prometheus-stack for the lab, chapter 5.1
# k3s runs etcd, scheduler, controller manager and proxy inside one process, their own monitors find nothingkubeEtcd: enabled: falsekubeControllerManager: enabled: falsekubeScheduler: enabled: falsekubeProxy: enabled: false
prometheus: service: type: NodePort nodePort: 30090 prometheusSpec: retention: 3d resources: requests: cpu: 100m memory: 512Mi # Read monitors, rules and scrape configs of every namespace, not only those of this chart serviceMonitorSelectorNilUsesHelmValues: false podMonitorSelectorNilUsesHelmValues: false ruleSelectorNilUsesHelmValues: false scrapeConfigSelectorNilUsesHelmValues: false storageSpec: volumeClaimTemplate: spec: accessModes: [ReadWriteOnce] resources: requests: storage: 5Gi
alertmanager: # Every alert goes to the receiver null, the advanced tasks add a receiver of their own config: route: receiver: "null" group_by: [alertname, namespace] group_wait: 30s group_interval: 5m repeat_interval: 4h receivers: - name: "null" service: type: NodePort nodePort: 30093 alertmanagerSpec: resources: requests: cpu: 10m memory: 64Mi
grafana: service: type: NodePort nodePort: 30300 # The password lives in a secret that make-secrets.sh creates, not in Git, part 6 replaces it with a SealedSecret admin: existingSecret: grafana-admin userKey: admin-user passwordKey: admin-password additionalDataSources: - name: Loki type: loki uid: loki url: http://loki.monitoring.svc:3100 # Dashboards from config maps with the label grafana_dashboard in any namespace sidecar: dashboards: enabled: true searchNamespace: ALLk3s führt Scheduler, Controller Manager und Proxy in einem einzigen Prozess aus. Die Monitore, die das Chart dafür mitbringt, fänden nichts und blieben rot. Darum sind sie abgeschaltet. Das README des Charts in der Version 92.17.0 beschreibt die Installation, die Werte und für Argo CD die Option ServerSideApply.
OpenNebula als Ziel
Abschnitt betitelt „OpenNebula als Ziel“Für die IaaS-Schicht bringt OpenNebula eigene Exporter mit, im Paket opennebula-prometheus-kvm. Der OpenNebula-Exporter läuft auf dem Front-end und liefert auf Port 9925 Hosts, VMs und Datastores, wie OpenNebula sie sieht. Auf dem Front-end und auf beiden Knoten liefert node_exporter auf Port 9100 die Werte des Betriebssystems. Die Knoten haben zusätzlich den Libvirt-Exporter auf Port 9926, er zeigt die VMs, wie KVM sie sieht. Das Paket opennebula-prometheus installierst du nicht, es brächte ein zweites Prometheus mit. Für die Exporter folgt das Skript unten der Anleitung von OpenNebula 7.4, die zusätzlich dieses Paket installiert.
#!/bin/bash# Installs the Prometheus exporters of OpenNebula, the step of chapter 5.1. Run it on the front-end.##   ~/cc/platform/observability/install-exporters.sh## Front-end: the OpenNebula exporter (port 9925) and node_exporter (9100).# Nodes: node_exporter (9100) and the libvirt exporter (9926).# The package opennebula-prometheus would bring a Prometheus of its own, the cluster already has one.set -euo pipefail
# shellcheck source=/dev/nullsource /etc/cc-lab.env
sudo apt-get install -y opennebula-prometheus-kvmsudo systemctl enable --now opennebula-exporter opennebula-node-exporter
for node in "$CC_NODE1_HOST" "$CC_NODE2_HOST"; do  ssh "$node" "sudo apt-get install -y opennebula-prometheus-kvm && sudo systemctl enable --now opennebula-node-exporter opennebula-libvirt-exporter"done
sleep 5for target in "$CC_FE_IP:9925" "$CC_FE_IP:9100" "$CC_NODE1_IP:9100" "$CC_NODE1_IP:9926" "$CC_NODE2_IP:9100" "$CC_NODE2_IP:9926"; do if curl -fs -o /dev/null "http://$target/metrics"; then echo "ok $target"; else echo "!! $target"; fidone~/cc/platform/observability/install-exporters.shIm Lab meldeten alle sechs Ziele ok. Der OpenNebula-Exporter kannte die Hosts wenige Sekunden bis eine halbe Minute nach dem Start. Prometheus erreicht die Exporter über drei ScrapeConfigs mit den Adressen aus deinen Parametern. Neue ScrapeConfigs und ServiceMonitors übernimmt Prometheus erst, wenn der Config-Reloader die geänderte Konfiguration sieht. Im Lab erschienen die Jobs der Ziele ausserhalb des Clusters zwei bis fünf Minuten nach dem Push, der Job webshop nach knapp vier Minuten.
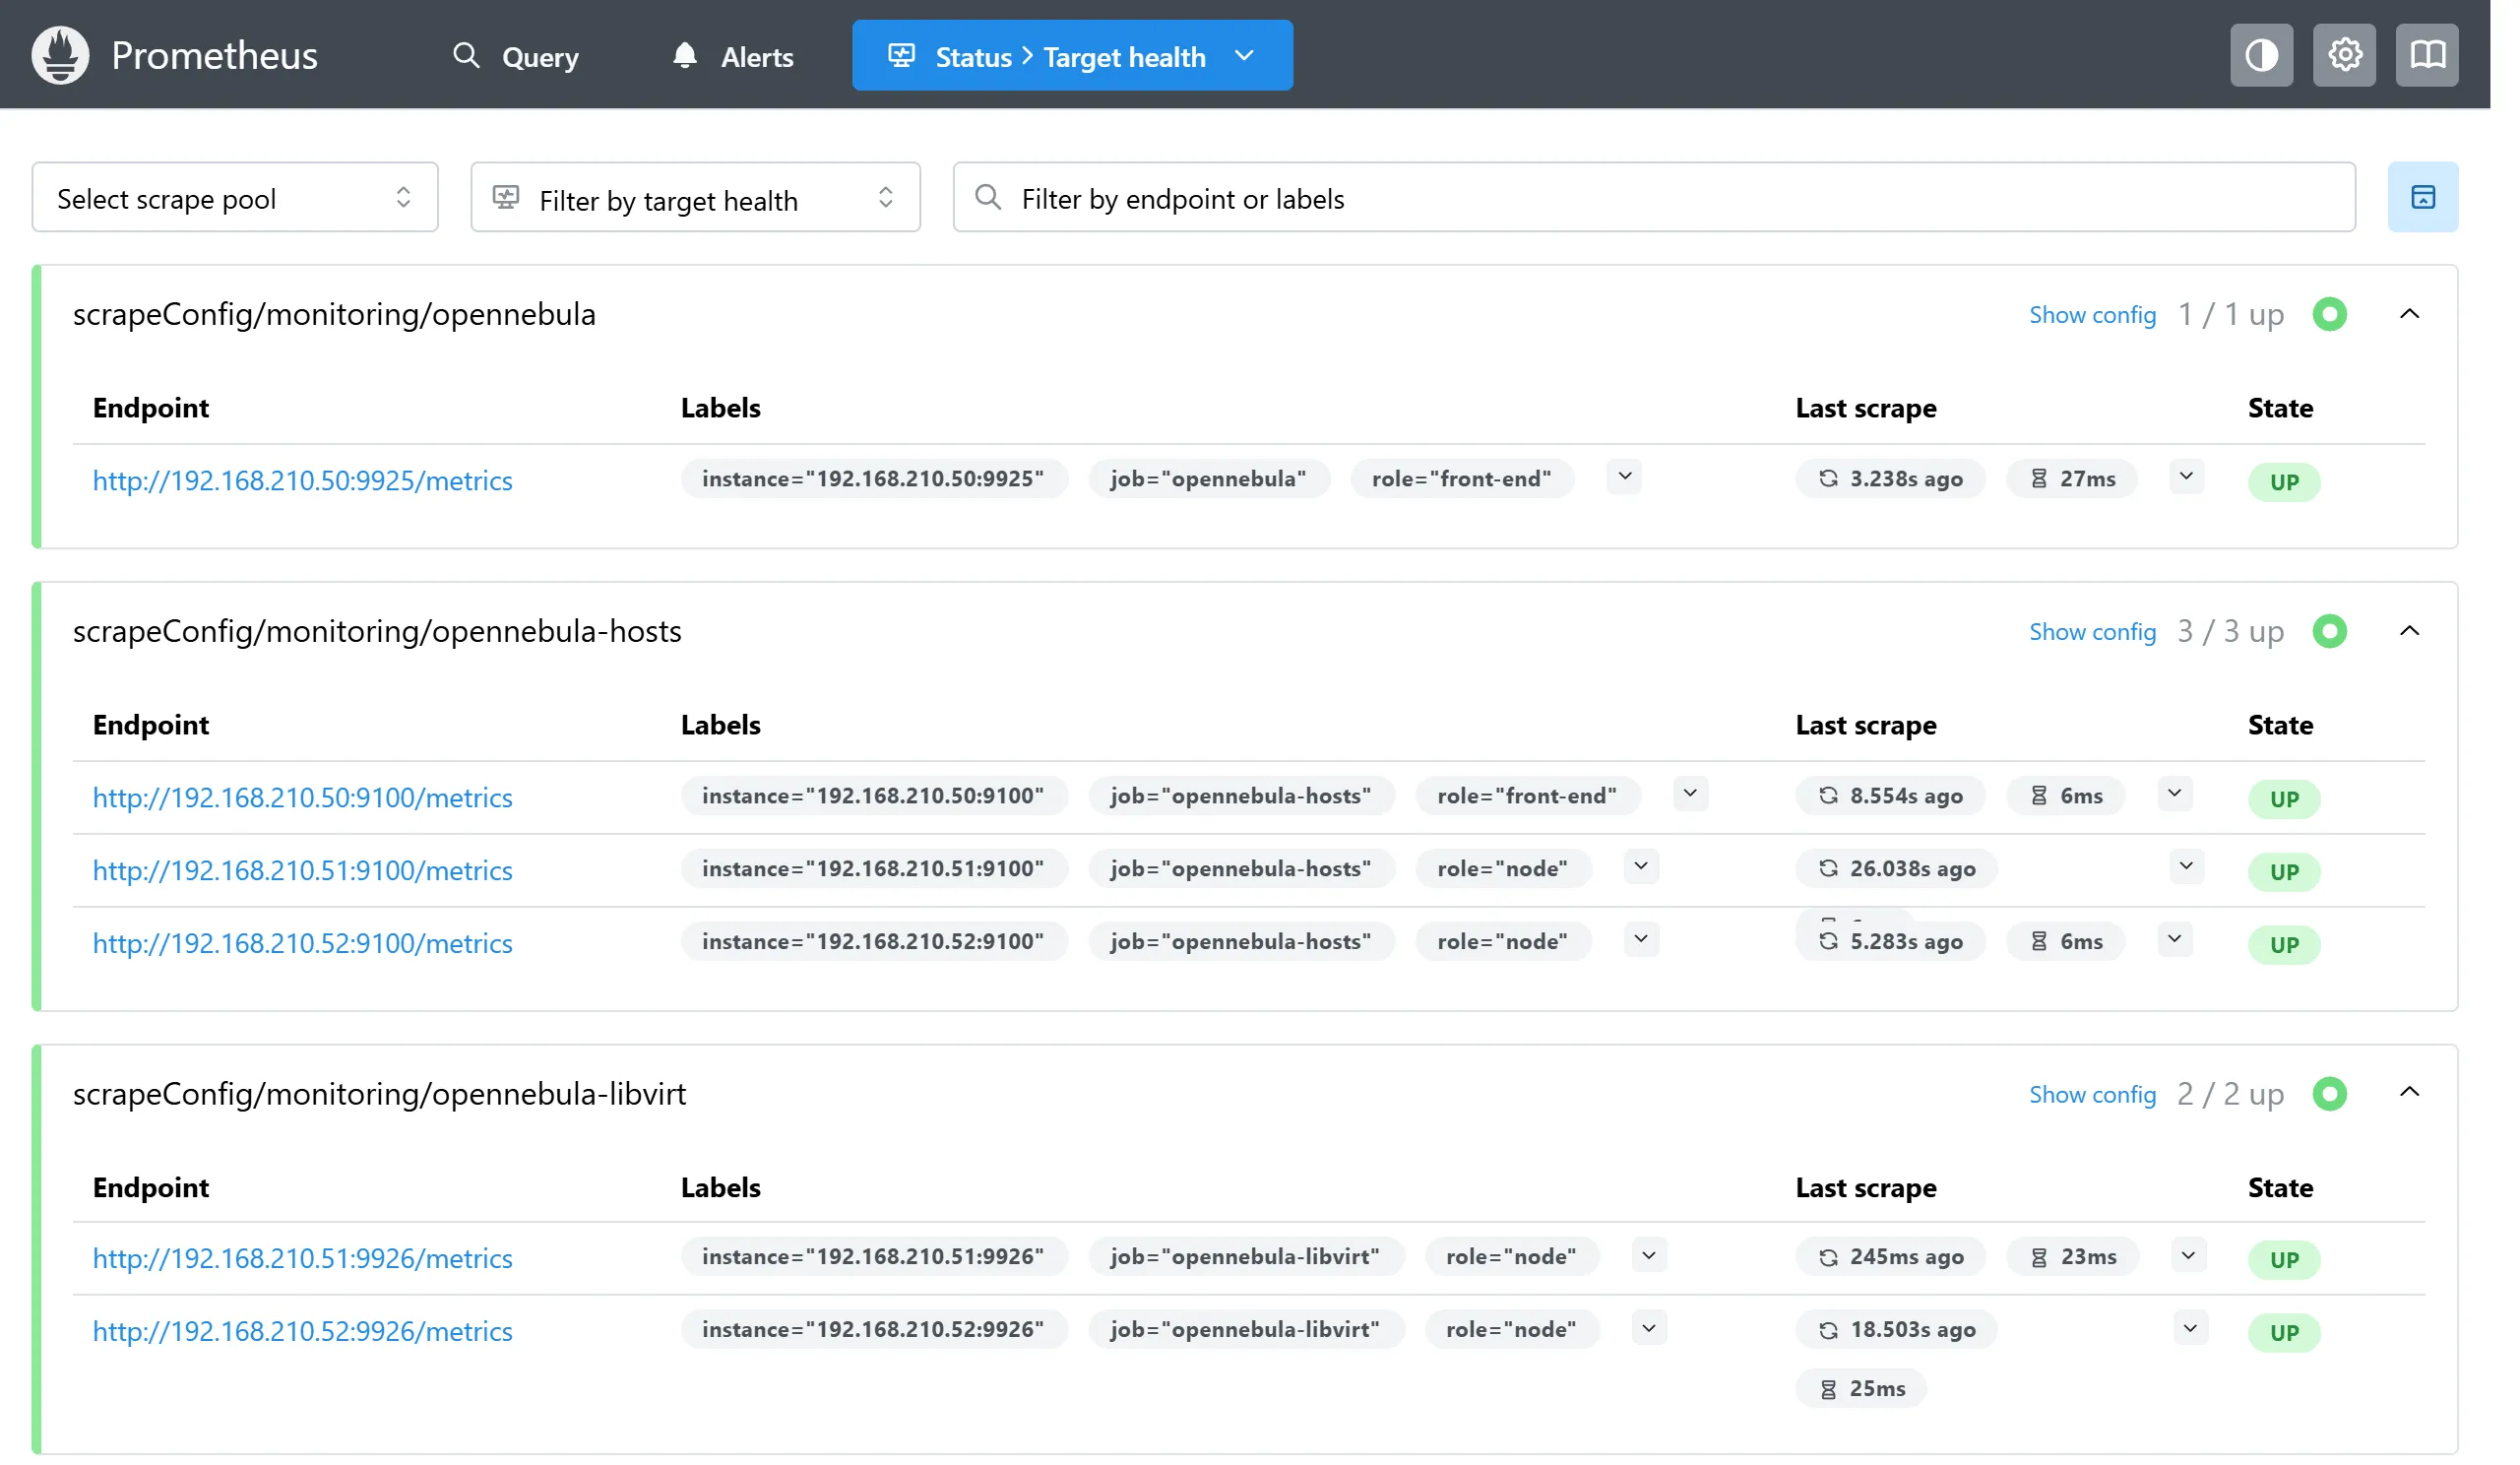
In Prometheus zeigt «Status › Target health» jedes Ziel mit seinem Zustand.
# The exporters of OpenNebula outside the cluster, the addresses come from the personal parametersapiVersion: monitoring.coreos.com/v1alpha1kind: ScrapeConfigmetadata: name: opennebulaspec: jobName: opennebula staticConfigs: - labels: role: front-end targets: - FRONTEND_IP:9925---apiVersion: monitoring.coreos.com/v1alpha1kind: ScrapeConfigmetadata: name: opennebula-hostsspec: jobName: opennebula-hosts staticConfigs: - labels: role: front-end targets: - FRONTEND_IP:9100 - labels: role: node targets: - NODE1_IP:9100 - NODE2_IP:9100---apiVersion: monitoring.coreos.com/v1alpha1kind: ScrapeConfigmetadata: name: opennebula-libvirtspec: jobName: opennebula-libvirt staticConfigs: - labels: role: node targets: - NODE1_IP:9926 - NODE2_IP:9926Der Webshop als Ziel
Abschnitt betitelt „Der Webshop als Ziel“Für den Webshop genügt ein ServiceMonitor neben seinem Deployment. Prometheus holt die Metriken dann bei jedem Pod hinter dem Service webshop ab.
# Prometheus reads /metrics of every web shop pod every 15 secondsapiVersion: monitoring.coreos.com/v1kind: ServiceMonitormetadata: name: webshopspec: selector: matchLabels: app: webshop endpoints: - port: http path: /metrics interval: 15sDie NetworkPolicy der Mitglieder aus Kapitel 4.5 liess bisher nur den eigenen Namespace und kube-system durch. Ohne Änderung käme Prometheus nicht an /metrics. Die neue Fassung der Vorlage lässt auch den Namespace monitoring zu.
# Pods of a member accept traffic only from their own namespace, from the ingress of k3s in kube-system# and from Prometheus in monitoringapiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: memberspec: podSelector: {} policyTypes: - Ingress ingress: - from: - podSelector: {} - namespaceSelector: matchLabels: kubernetes.io/metadata.name: kube-system - namespaceSelector: matchLabels: kubernetes.io/metadata.name: monitoringSobald du alles gepusht hast, rollt Argo CD den Stack aus. Im Lab war er 140 bis 160 Sekunden nach dem Push synchron und gesund.
git add .git commit -m "Überwachung mit Prometheus, Grafana und den Exportern von OpenNebula"git pushkubectl -n monitoring get podsPrometheus und Grafana erreichst du wie Argo CD über einen Tunnel, Prometheus auf Port 30090 und Grafana auf Port 30300 des Servers. Den Tunnel öffnest du vom Client aus, auf smartlearn ist das die Kali-VM, mit eigenem Hypervisor dein PC.
ssh -L 9090:<adresse-des-servers>:30090 -L 3000:<adresse-des-servers>:30300 mmuster-feIm Browser des Clients zeigt Prometheus unter http://localhost:9090/targets jedes Ziel mit seinem Zustand. Im Lab waren alle up, auch die Jobs von OpenNebula (opennebula, opennebula-hosts, opennebula-libvirt) und der Job webshop. Unter «Query» probierst du Abfragen aus.
| Abfrage | Ergebnis |
|---|---|
up | 1 für jedes erreichbare Ziel, 0 sonst |
opennebula_host_mem_usage_bytes / opennebula_host_mem_total_bytes | Anteil des Speichers jedes Knotens, den VMs belegen |
rate(webshop_requests_total[5m]) | Anfragen pro Sekunde, gemittelt über fünf Minuten |
sum by (code) (rate(webshop_requests_total[5m])) | dasselbe, nach Statuscode zusammengezählt |
histogram_quantile(0.95, sum by (le) (rate(webshop_request_duration_seconds_bucket[5m]))) | Zeit, in der 95 % der Anfragen beantwortet sind |
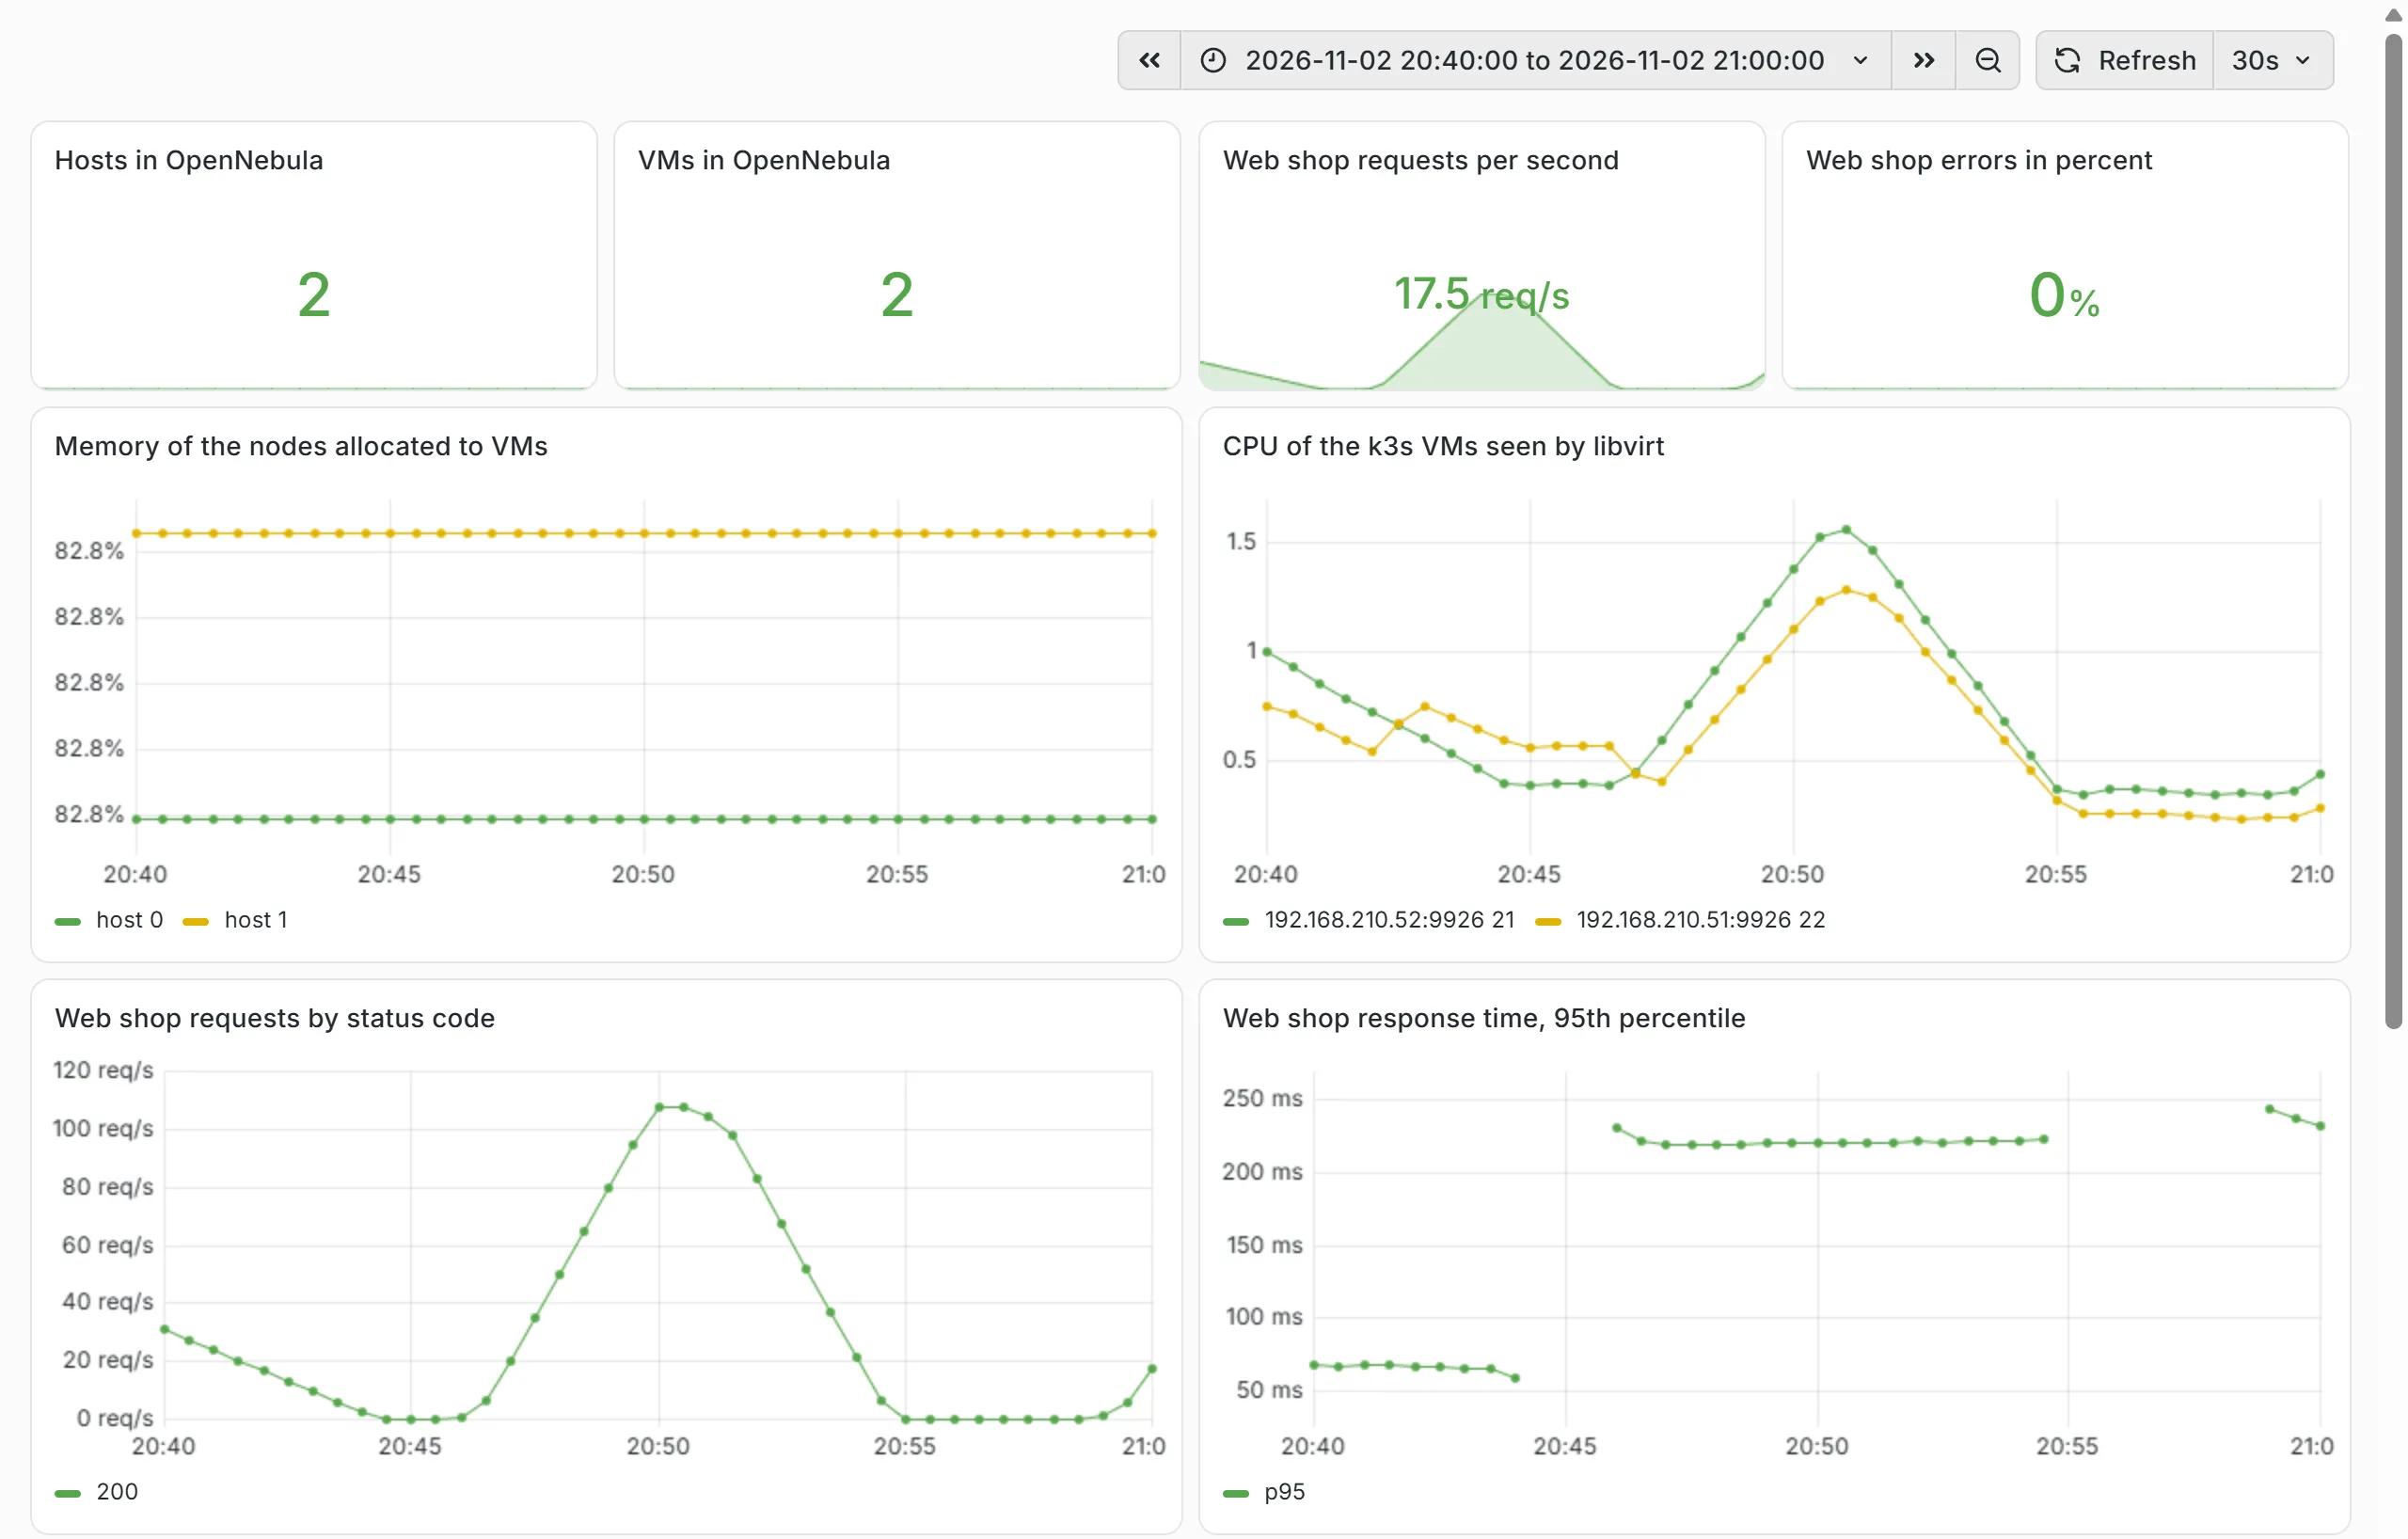
Ein Counter allein sagt wenig, weil er seit dem Start des Pods nur steigt. rate() macht daraus eine Änderung pro Sekunde und übersteht auch Neustarts, bei denen der Counter auf null fällt. sum by fasst Zeitreihen zusammen und behält nur die genannten Labels. Im Lab belegten die k3s-VMs laut der zweiten Abfrage auf jedem Knoten 83 % des Speichers, den OpenNebula vergeben kann.
Grafana
Abschnitt betitelt „Grafana“Grafana zeigt Abfragen als Dashboards. Im Browser des Clients meldest du dich unter http://localhost:3000/ als admin an, mit dem Passwort aus ~/cc-lab/grafana.pass auf dem Front-end. Das Chart bringt Dashboards für Kubernetes mit, etwa «Kubernetes / Compute Resources / Namespace (Pods)». Dazu kommt ein Dashboard des Plattform-Teams aus Git, monitoring/config/dashboard-wolkenwerk.yaml. Es zeigt Hosts und VMs von OpenNebula, Verkehr, Fehler und Antwortzeit des Webshops, CPU pro Namespace und den Speicher der Mitglieder gegen ihre Quota. Grafana lädt jede ConfigMap mit dem Label grafana_dashboard von selbst.
Für ein eigenes Panel kopierst du in monitoring/config/dashboard-wolkenwerk.yaml ein bestehendes Panel. Gib ihm einen eigenen title, deine Abfrage in expr und einen freien Platz in gridPos, etwa unter den bestehenden Panels mit "y": 28. Die Panels der Datei haben keine id, auch dein Panel braucht keine. Pushe danach die Änderung. Ein Panel, das du in Grafana entworfen hast, findest du als JSON im Menü des Panels unter «Inspect» und «Panel JSON». Die Felder eines Dashboards und seiner Panels beschreibt das JSON-Modell von Grafana 13.3.
Aufgabe Lab
Rolle den Stack aus, installiere die Exporter und zeige in Prometheus, dass alle Ziele up sind. Öffne das Dashboard «Wolkenwerk platform» und erzeuge mit curl Verkehr auf den Webshop.
Lösung
kubectl -n argocd get applications zeigt monitoring und monitoring-config als Synced und Healthy. Unter Targets stehen die Jobs opennebula mit einem Ziel, opennebula-hosts mit drei, opennebula-libvirt mit zwei und webshop mit einem Ziel pro Pod. Nach einigen curl http://<adresse-des-servers>/ zeigt das Dashboard Anfragen mit dem Code 200.
Aufgabe Eigene Abfrage
Die Gemeinde Hinterbüel will wissen, wie viele VMs gerade in OpenNebula laufen und wie viel CPU sie insgesamt beanspruchen. Schreibe die Abfragen.
Lösung
count(opennebula_vm_state == 3) zählt die VMs im Zustand aktiv. Welche Zahl für welchen Zustand steht, beschreibt der Exporter im Hilfetext der Metrik. sum(opennebula_host_cpu_usage_ratio) zählt die CPU zusammen, die OpenNebula auf allen Knoten an VMs vergeben hat. Wer statt der Zuteilung die echte Last will, nimmt sum(rate(opennebula_libvirt_cpu_seconds_total[5m])) von den Knoten.
Aufgabe Sättigung
Welche Abfrage hätte dir in Kapitel 4.2 gezeigt, dass der Cluster neben den VMs aus Teil 2 und 3 keinen Platz hat?
Lösung
opennebula_host_mem_total_bytes - opennebula_host_mem_usage_bytes zeigt pro Knoten den Speicher, den OpenNebula noch vergeben kann. Mit den Webservern, den VMs der Praxis und dem Dienst der Treuhand lag er unter den 6 GB, die eine VM des Clusters braucht.
Texte und Abbildungen stehen unter CC BY-SA 4.0 und der Code unter der MIT-Lizenz. Die Quellen liegen auf GitHub.