Backup und Wiederherstellung
Auftrag
«Die neue Organisation fragt, was bei einem Ausfall passiert», schreibt Simone Wyss. «Wie lange sind wir weg und wie viele Daten verlieren wir? Und probiert es bitte einmal aus, statt es nur zu behaupten.»
Lernziele
Nach diesem Kapitel kannst du:
- RPO und RTO für einen Dienst festlegen und begründen
- Unterscheiden, was Git abdeckt und was ein Backup braucht
- Den Cluster mit etcd und regelmässigen Snapshots betreiben
- VMs in OpenNebula sichern und wiederherstellen
- Eine Wiederherstellung üben und die Zeit messen
RPO und RTO
Abschnitt betitelt „RPO und RTO“Zwei Zahlen beschreiben, was ein Ausfall kosten darf. Das Recovery Point Objective (RPO) ist der Zeitpunkt, bis zu dem Daten nach einem Ausfall wiederhergestellt sein müssen. Wer jede Nacht sichert, kann bis zu 24 Stunden Daten verlieren. Das Recovery Time Objective (RTO) ist die längste Zeit, die ein Dienst ausfallen darf, bevor der Schaden nicht mehr tragbar ist. Beide Begriffe stammen aus der Notfallplanung. Das NIST definiert sie in SP 800-34.
Ein kleines RPO verlangt häufige Backups, ein kleines RTO eine schnelle und geübte Wiederherstellung. Beides kostet. Die Treuhand verliert am Monatsende ungern einen halben Tag Buchungen, der Webshop verkraftet einen verlorenen Tag Logs ohne Weiteres.
Als Faustregel gilt die Regel 3-2-1, die die amerikanische Behörde CISA in Data Backup Options beschreibt. Man hält drei Kopien wichtiger Daten auf zwei verschiedenen Medien, eine davon ausser Haus.
Grenzen von Git
Abschnitt betitelt „Grenzen von Git“Seit Teil 4 steht der Soll-Zustand der Plattform in Git. Ein neuer Cluster holt sich daraus alle Anwendungen, Vorlagen und Regeln. Vieles andere liegt aber nicht in Git.
| Was | Wo | Gesichert durch |
|---|---|---|
| Manifeste, Charts, Regeln, SealedSecrets | Repo platform in Gitea | Git, mit Kopie auf dem Front-end in ~/platform |
| State von OpenTofu | ~/platform/tofu/terraform.tfstate | nicht in Git, enthält das Token von k3s |
| Zustand des Clusters, etwa Secrets und Passwort von Argo CD | etcd auf dem Server | Snapshots von k3s |
| Token von k3s, Schlüssel von Sealed Secrets | Server und Cluster | backup-k3s.sh |
| Daten in Volumes, etwa Prometheus, Loki, Audit-Log | Disk des Agents | in diesem Kurs nicht |
| VMs der Mitglieder | Datastores der Knoten | Backups von OpenNebula |
Das Repo in Gitea liegt wie der State, die Snapshots und die Backups auf dem Front-end. Fällt das Front-end aus, sind alle vier zugleich weg. Das verletzt die Regel 3-2-1. Eine Kopie gehört auf ein anderes System, etwa auf den Rechner der Dozentin oder des Dozenten oder in einen Speicher ausser Haus.
Der Cluster mit etcd
Abschnitt betitelt „Der Cluster mit etcd“In Teil 4 hast du k3s mit seiner Standard-Datenbank SQLite installiert. Für Snapshots braucht k3s etcd. Die Vorlage aus den Ergänzungen von Teil 6 startet den Server mit --cluster-init und lässt k3s alle sechs Stunden einen Snapshot schreiben, acht davon bleiben auf dem Server. Die Optionen beschreibt die Dokumentation von k3s.
#!/bin/sh# Runs at every boot through the OpenNebula context, k3s installs only oncecommand -v k3s >/dev/null 2>&1 && exit 0
# Pods and services get their own ranges, the defaults 10.42.0.0/16 and 10.43.0.0/16 can overlap a lab network.# host-gw routes pod traffic directly, both VMs share cc-net and VXLAN inside VXLAN loses packets in nested VMs.# --cluster-init keeps the cluster state in etcd instead of SQLite, k3s then takes a snapshot every six hours and keeps eight%{ if role == "server" ~}curl -sfL https://get.k3s.io | INSTALL_K3S_VERSION="${k3s_version}" K3S_TOKEN="${token}" sh -s - server \  --tls-san ${ip} \  --cluster-init \  --etcd-snapshot-schedule-cron "0 */6 * * *" \  --etcd-snapshot-retention 8 \  --cluster-cidr 10.52.0.0/16 \  --service-cidr 10.53.0.0/16 \  --flannel-backend host-gw%{ else ~}until curl -ksf https://${server_ip}:6443/ping >/dev/null; do sleep 5; donecurl -sfL https://get.k3s.io | INSTALL_K3S_VERSION="${k3s_version}" K3S_URL="https://${server_ip}:6443" K3S_TOKEN="${token}" sh -s - agent%{ endif ~}
Die Datei kam beim Kopieren in Kapitel 6.1 in dein Repo. tofu plan zeigt nur eine Änderung am Kontext der beiden VMs. Das Startskript läuft zwar bei jedem Start, endet aber sofort, wenn k3s schon installiert ist. Eine geänderte Installation wirkt deshalb erst auf neuen VMs. Du baust den Cluster also neu. Die Option -replace ersetzt dabei beide VMs. Sie gehört zu den Optionen von tofu plan, die auch tofu apply annimmt. Das ist zugleich die erste Übung zur Wiederherstellung, denn der Neubau zeigt, wie viel Git allein zurückbringt.
mkdir -p ~/backup/k3s && chmod 700 ~/backup ~/backup/k3s(umask 077; kubectl -n kube-system get secret -l sealedsecrets.bitnami.com/sealed-secrets-key -o yaml > ~/backup/k3s/sealed-secrets-key.yaml)cd ~/platform/tofuexport OPENNEBULA_USERNAME=oneadminexport OPENNEBULA_PASSWORD=$(cut -d: -f2- ~/.one/one_auth)tofu apply -replace='opennebula_virtual_machine.k3s["k3s-server"]' -replace='opennebula_virtual_machine.k3s["k3s-agent"]'Danach folgen die Schritte aus den Kapiteln 4.3 und 4.4. Den Schlüssel spielst du vor Argo CD ein, wie es die Dokumentation von Sealed Secrets für eine Wiederherstellung beschreibt.
source /etc/cc-lab.envssh-keygen -R $CC_K3S_SERVER_IP; ssh-keygen -R $CC_K3S_AGENT_IP~/cc/platform/get-kubeconfig.shkubectl apply -f ~/backup/k3s/sealed-secrets-key.yaml~/cc/platform/bootstrap-argocd.shMit dem ganzen Stack aus Teil 5 dauerte tofu apply für diesen Neubau im Lab knapp drei Minuten. Davon warteten die alten VMs 104 Sekunden auf ihr Herunterfahren. OpenNebula hielt zudem eine der neuen VMs in pending und meldete «Not enough capacity on datastores». Für die freie Disk eines Knotens kannte OpenNebula noch den alten Wert. onevm show <id> | grep SCHED_MESSAGE zeigt den Grund. Nach onehost forceupdate lief die VM eine halbe Minute später. Das neue Passwort von Argo CD schreibt das Skript nach ~/cc-lab/argocd-admin.pass statt auf den Bildschirm, damit es in keinem Screenshot landet. Nach dem Bootstrap rollte Argo CD alles aus. Der Webshop antwortete 50 Sekunden später, nach gut eineinhalb Minuten waren alle Applications synchron und gesund. Auch das Passwort von Grafana war wieder entschlüsselt. Vom Start von tofu apply an vergingen gut fünf Minuten. Verloren waren die Daten in den Volumes, also die Metriken und die Logs. Im Lab des Kurses liefen auch Ollama und ein Triage-Dienst aus den Zusatzaufträgen von Meilenstein 3. Ollama lud sein Modell neu, das Audit-Log des Triage-Dienstes war weg.
Snapshots sichern
Abschnitt betitelt „Snapshots sichern“Ein Snapshot auf dem Server hilft nicht, wenn der Server selbst verloren ist. Das Skript kopiert die Snapshots auf das Front-end, dazu das Token von k3s und den Schlüssel von Sealed Secrets.
#!/bin/bash# Copies the etcd snapshots and the token of the k3s server and the key of Sealed Secrets to the front-end, chapter 6.2.# A snapshot alone is not enough for a restore, k3s also needs the token of the old server.# Without the key a new cluster cannot decrypt the SealedSecrets in Git.##   ~/cc/platform/operations/backup-k3s.sh## A systemd timer runs it every six hours, see install-backup-timer.sh.set -euo pipefail
# shellcheck source=/dev/nullsource /etc/cc-lab.envdest=~/backup/k3smkdir -p "$dest/snapshots"chmod 0700 ~/backup "$dest"kubectl -n kube-system get secret -l sealedsecrets.bitnami.com/sealed-secrets-key -o yaml > "$dest/sealed-secrets-key.yaml"chmod 0600 "$dest/sealed-secrets-key.yaml"# Right after a rebuild the server has no snapshot yet, token and key are still worth copyingif ssh "root@$CC_K3S_SERVER_IP" 'ls /var/lib/rancher/k3s/server/db/snapshots/* >/dev/null 2>&1'; then  scp -q -p "root@$CC_K3S_SERVER_IP:/var/lib/rancher/k3s/server/db/snapshots/*" "$dest/snapshots/"fiscp -q -p "root@$CC_K3S_SERVER_IP:/var/lib/rancher/k3s/server/token" "$dest/token"chmod 0600 "$dest/token"# k3s keeps eight snapshots on the server, the front-end keeps the last seven daysfind "$dest/snapshots" -type f -mtime +7 -deleteecho "$(date -Is) $(find "$dest/snapshots" -type f | wc -l) snapshots in $dest"
Ubuntu 26.04 bringt kein cron mit. Ein Timer von systemd startet das Skript alle sechs Stunden, eine halbe Stunde nach den Snapshots von k3s. Die Einstellungen eines Timers beschreibt die Handbuchseite von systemd.timer.
Direkt nach dem Neubau hat k3s noch keinen Snapshot. Der erste entsteht erst zur nächsten vollen sechsten Stunde, darum legst du vor der ersten Kopie einen von Hand an.
source /etc/cc-lab.envssh root@$CC_K3S_SERVER_IP k3s etcd-snapshot savesudo ~/cc/platform/operations/install-backup-timer.shsudo systemctl start cc-backup-k3s.servicels ~/backup/k3s/snapshotsDas RPO des Clusters beträgt damit sechs Stunden. Was in dieser Zeit über kubectl statt über Git geändert wurde, wäre nach einer Wiederherstellung weg. Die Wiederherstellung aus einem Snapshot gehört zu Zusatzauftrag B in Kapitel 6.5.
VMs in OpenNebula
Abschnitt betitelt „VMs in OpenNebula“Die VMs der Mitglieder sichert OpenNebula selbst. Backups landen in einem Datastore vom Typ BACKUP_DS. In der Community Edition gibt es dafür die Treiber rsync und restic. Die Dokumentation von OpenNebula beschreibt beide. Der Kurs nimmt rsync, das die Disks über SSH auf das Front-end kopiert.
#!/bin/bash# Creates the backup datastore of OpenNebula on the front-end, chapter 6.2.# The driver rsync copies the disks of a VM over SSH to the front-end.##   ~/cc/platform/operations/backup-datastore.shset -euo pipefail
# shellcheck source=/dev/nullsource /etc/cc-lab.envif ! onedatastore show backups >/dev/null 2>&1; then  tmpl=$(mktemp)  cat > "$tmpl" <<TMPLNAME       = "backups"TYPE       = "BACKUP_DS"DS_MAD     = "rsync"TM_MAD     = "-"RSYNC_USER = "oneadmin"RSYNC_HOST = "$CC_FE_IP"TMPL  onedatastore create "$tmpl"  rm -f "$tmpl"fionedatastore show backups | grep -E '^(ID|NAME|STATE)'
Seit Kapitel 4.2 laufen in OpenNebula nur noch die beiden VMs von k3s. Diese beiden sicherst du nicht auf diesem Weg, ihr Zustand steckt in Git und in den Snapshots von etcd. Zum Üben startest du als praxis-admin die VM praxis-1 aus der Vorlage ubuntu mit 1 GB. Mehr Speicher hat ein Knoten neben k3s nicht frei. Diese VM sicherst du und stellst sie wieder her. Damit du die Wiederherstellung prüfen kannst, legst du vor dem Backup eine Testdatei an. onevm show zeigt die Adresse der VM. Machst du Zusatzauftrag A aus Kapitel 6.5, kannst du stattdessen die VM deines eigenen Mitglieds nehmen.
Ein Backup von Hand startet onevm backup, auch bei einer laufenden VM. Das Backup einer VM mit 1 GB Speicher und Ubuntu 26.04 dauerte im Lab sechs bis elf Sekunden. Das Backup-Image war 1004 MB gross.
ONE_AUTH=~/cc-lab/tenants/praxis.auth onetemplate instantiate ubuntu --name praxis-1ssh root@<adresse-der-vm> 'echo vor dem Backup > /root/testdatei.txt && sync'~/cc/platform/operations/backup-datastore.shonevm backup -d backups <vm>oneimage listBei einer laufenden VM enthält das Backup nur, was schon auf ihrer Disk steht. Ubuntu schreibt Änderungen an der Root-Partition erst nach bis zu 30 Sekunden auf die Disk, sync erzwingt es sofort. Ohne sync fehlte die Testdatei im Lab nach der Wiederherstellung, das Backup war sieben Sekunden nach dem Anlegen gelaufen. Eine Datenbank in der VM hält ebenfalls Daten im Arbeitsspeicher. Ihr Backup ist dann so vollständig wie nach einem Stromausfall. OpenNebula friert das Dateisystem vor dem Backup nicht ein, onebackupjob show zeigt dafür die Einstellung FS_FREEZE="NONE".
Regelmässige Backups übernimmt ein Backup-Job, wie ihn die Dokumentation von OpenNebula 7.4 beschreibt. Das Skript legt einen an, der jede Nacht sichert. Ohne weitere Angaben läuft er um 2 Uhr und behält sieben Backups. Uhrzeit und Anzahl kannst du mitgeben, für Meilenstein 4 die Zahlen aus deinen persönlichen Werten. Die Uhrzeit gilt in der Zeitzone des Front-ends, die timedatectl anzeigt.
~/cc/platform/operations/backup-job.sh praxis-nightly <vm> <stunde> <anzahl>onebackupjob list#!/bin/bash# Creates a backup job in OpenNebula that backs up VMs every night, by default at 2.00 and keeping seven backups, chapter 6.2.## ~/cc/platform/operations/backup-job.sh <name> <VM IDs separated by commas> [hour] [backups to keep]# ~/cc/platform/operations/backup-job.sh velo-nightly 21,22# ~/cc/platform/operations/backup-job.sh praxis-nightly 15 4 10## The hour is in the time zone of the front-end, timedatectl shows it.set -euo pipefail
name=${1:?name of the job}vms=${2:?VM IDs, for example 21,22}hour=${3:-2}keep=${4:-7}# The first run is tonight if the hour is still ahead, otherwise the next nightfirst=$(date -d "today $hour:00" +%s)[ "$first" -gt "$(date +%s)" ] || first=$(date -d "tomorrow $hour:00" +%s)ds=$(onedatastore show backups --json | python3 -c 'import json, sys; print(json.load(sys.stdin)["DATASTORE"]["ID"])')tmpl=$(mktemp)# REPEAT 0 means weekly, on the days 0 to 6, so every day. TIME is the first run in seconds since 1970cat > "$tmpl" <<TMPLNAME = "$name"BACKUP_VMS = "$vms"DATASTORE_ID = "$ds"KEEP_LAST = "$keep"MODE = "FULL"SCHED_ACTION = [ REPEAT = "0", DAYS = "0,1,2,3,4,5,6", END_TYPE = "0", TIME = "$first" ]TMPLonebackupjob create "$tmpl"rm -f "$tmpl"onebackupjob show "$name" | sed -n '/SCHEDULED ACTIONS/,/^$/p'Sunstone zeigt den Job unter «Storage › BackupJobs». Der Reiter «Info» nennt den letzten Lauf und die Werte des Jobs.
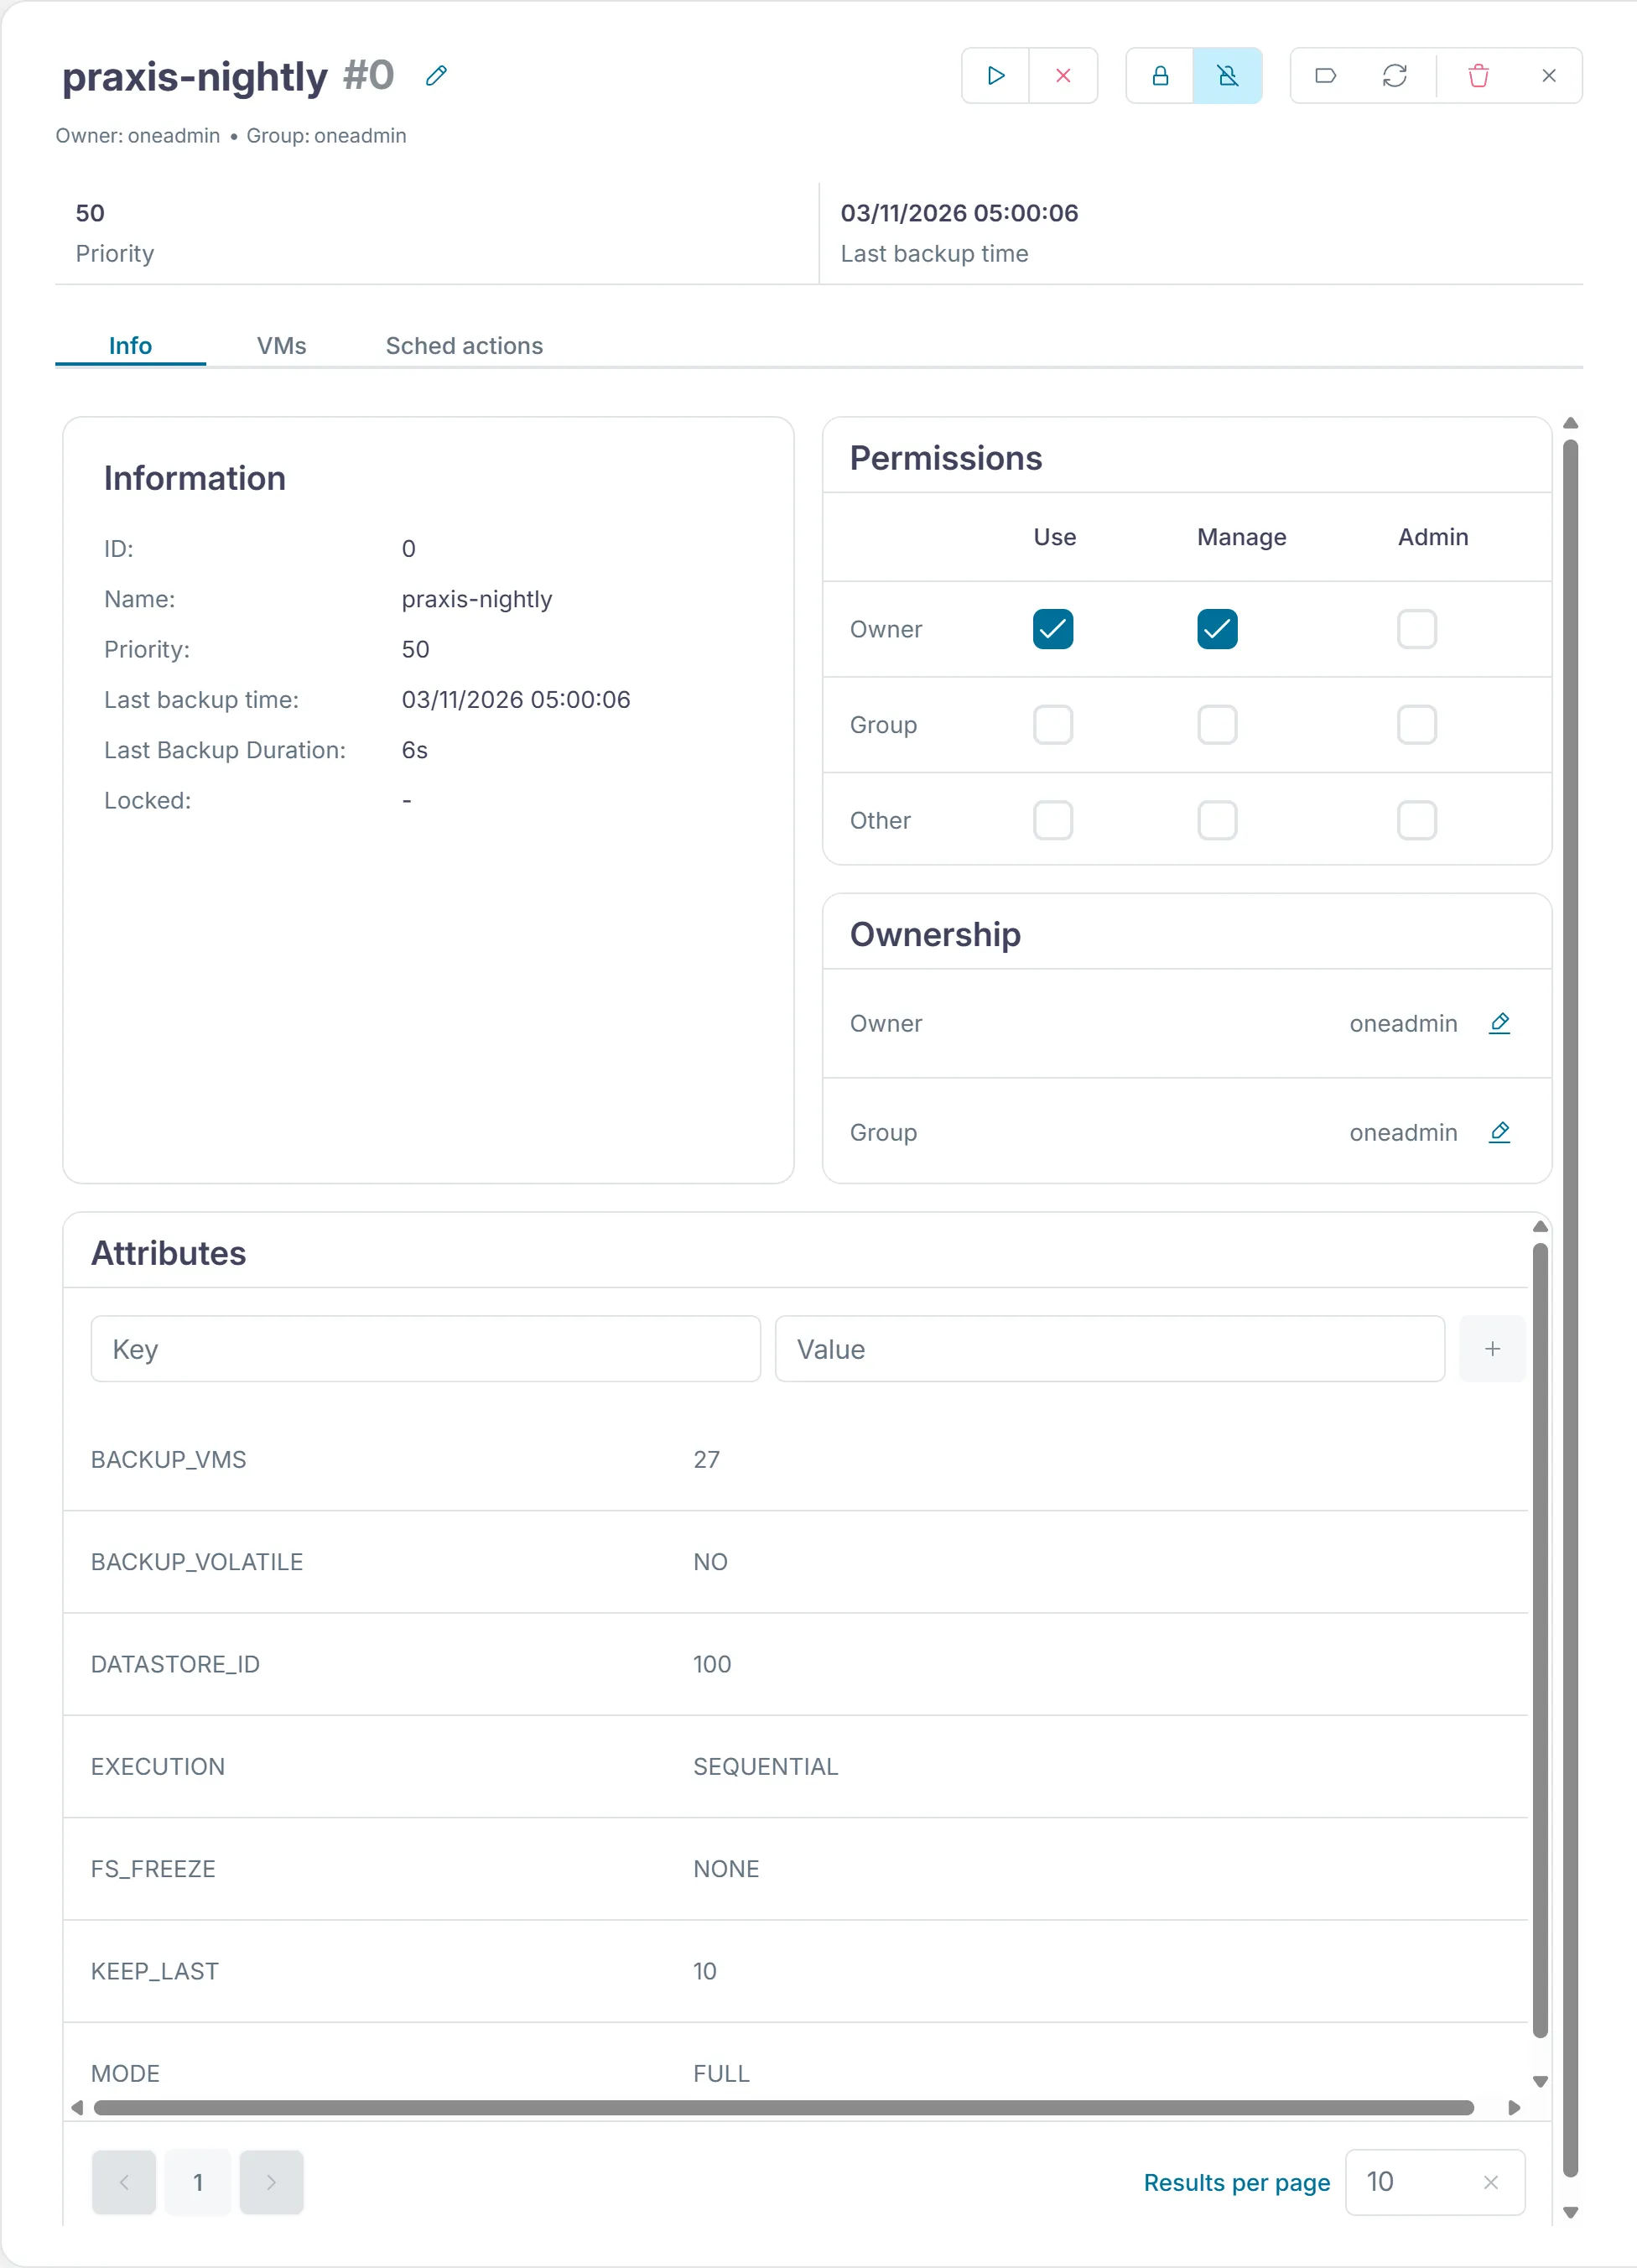
Steht eine VM in einem Backup-Job, lehnt onevm backup sie ab. Ein Backup ausser der Reihe startest du dann mit onebackupjob backup praxis-nightly, es sichert alle VMs des Jobs.
Zur Wiederherstellung macht oneimage restore aus einem Backup eine neue Vorlage mit einem neuen Image. Die Dokumentation von OpenNebula nennt diesen Weg Full Restore. Im Lab enthielt die neue VM 20 Sekunden bis eine Minute nach dem Befehl wieder die Testdatei von vor dem Backup. Vorlage, Image und VM gehören danach oneadmin. Mit onevm chown gibst du die VM dem Mitglied zurück. Die neue VM hat eine neue Nummer. Damit der Backup-Job sie weiter sichert, trägst du sie in den Job ein.
onevm terminate --hard <vm>oneimage restore -d default <backup-image>onetemplate instantiate <neue-vorlage> --name <name>onevm chown <neue-vm> <benutzer> <gruppe>echo 'BACKUP_VMS="<neue-vm>"' > /tmp/job.tplonebackupjob update praxis-nightly /tmp/job.tpl --appendIhr erstes eigenes Backup bekommt die neue VM in der nächsten Nacht. Willst du nicht so lange warten, holt onebackupjob backup praxis-nightly es sofort nach.
In Sunstone stehen die Backups unter «Storage › Backups».
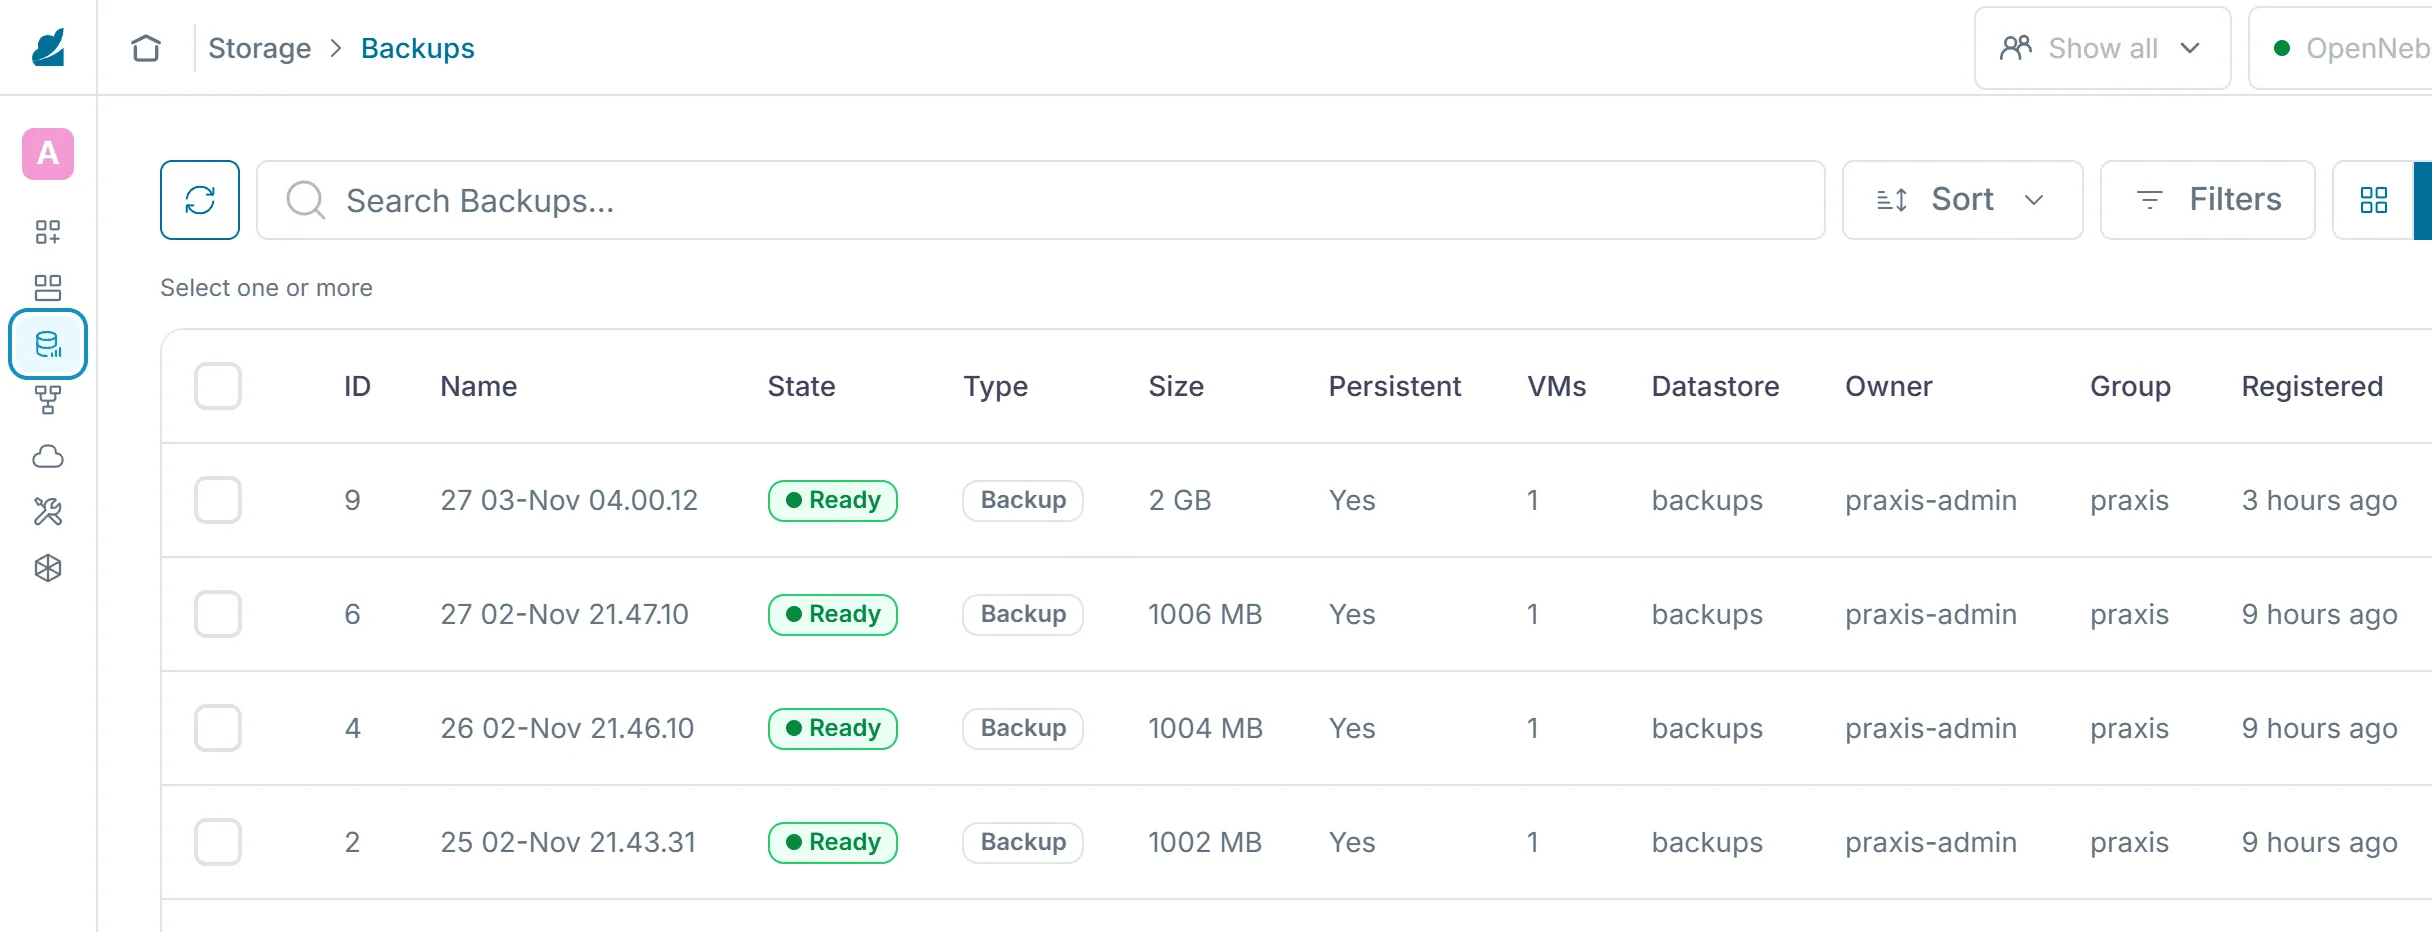
Backups zählen zur Quota des Datastores. Ein Mitglied mit vielen grossen Backups braucht dort Platz. Dieser Platz kostet Geld, Kapitel 6.4 kommt darauf zurück.
Ausblick
Abschnitt betitelt „Ausblick“Velero sichert Namespaces samt ihren Volumes in einen Objektspeicher und stellt einzelne Namespaces wieder her, ohne den ganzen Cluster zurückzusetzen. Es bräuchte einen Speicher wie MinIO und weitere Komponenten auf den knappen Knoten. Für den Kurs genügen Git, die Snapshots von etcd und die Backups von OpenNebula.
Der Check von Teil 6
Abschnitt betitelt „Der Check von Teil 6“Der Check dieses Teils prüft aus Kapitel 6.1 das gehärtete Front-end, also SSH nur mit Schlüssel, die Firewall und die automatischen Updates. Für die erste Prüfung versucht er selbst, sich ohne Schlüssel am Front-end anzumelden. Dazu kommen die Applications sealed-secrets und secrets, das Passwort von Grafana aus dem SealedSecret und das Profil restricted in allen Namespaces der Mitglieder. Aus diesem Kapitel prüft er die Snapshots von etcd, ihre Kopie mit Token und Schlüssel auf dem Front-end, den Timer, den Backup-Datastore, einen Backup-Job mit Zeitplan und ein Backup einer VM. Starte ihn auf dem Front-end, sobald der Backup-Job steht.
python3 ~/cc/checks/check.py operationsDie vier Zeilen zum neuen Mitglied mit [+!!] gehören zum Zusatzauftrag A in Kapitel 6.5 und zählen nicht zur Basis.
Aufgabe RPO und RTO
Lege für die vier Mitglieder ein RPO und ein RTO fest. Prüfe, ob die Plattform sie mit den Snapshots alle sechs Stunden und den nächtlichen Backups erreicht. Machst du die Zusatzaufträge aus Kapitel 6.5, ergänzt du dein eigenes Mitglied.
Lösung
Eine mögliche Festlegung ist die Treuhand mit RPO vier Stunden und RTO vier Stunden am Monatsende, die Praxis mit RPO 24 Stunden und RTO einem Arbeitstag, der Webshop mit RPO 24 Stunden und RTO einer Stunde am Samstag, die Gemeinde mit RPO 24 Stunden und RTO vier Stunden zu den Schalterzeiten. Die nächtlichen Backups der VMs erreichen ein RPO von 24 Stunden, die Treuhand bräuchte häufigere. Ein RTO von einer Stunde verlangt eine geübte Wiederherstellung. Im Lab dauerte der Neubau des Clusters gut fünf Minuten, die Wiederherstellung aus dem Snapshot unter einer Minute.
Aufgabe Lab
Baue den Cluster mit etcd neu, richte die Sicherung der Snapshots und einen Backup-Job ein und stelle die VM praxis-1 aus ihrem Backup wieder her. Miss die Zeiten. Lass zum Schluss den Check operations laufen und lade seinen Bericht in dein Abgabe-Repo.
Lösung
Auf dem Server zeigt k3s etcd-snapshot ls die Snapshots. In ~/backup/k3s liegen Snapshots, Token und Schlüssel. Den nächsten Lauf des Timers zeigt systemctl list-timers cc-backup-k3s.timer. onebackupjob list zeigt den Job, oneimage list ein Image vom Typ BK. Danach ist die VM zurück und enthält die Testdatei. Die Zeiten liegen im Bereich des Labs, gut fünf Minuten für den Neubau und unter einer Minute für die VM. Der Check endet mit «14 von 14 Prüfungen der Basis erfüllt» und «0 von 4 Prüfungen der Zusatzaufträge erfüllt».
Aufgabe Drei Kopien
Alle Backups liegen auf dem Front-end. Beschreibe, was bei einem Verlust des Front-ends verloren wäre. Schlage danach einen Weg zur Regel 3-2-1 vor, der zum Budget einer kleinen Genossenschaft passt.
Lösung
Mit dem Front-end wären Gitea, der State von OpenTofu, die Snapshots, die Backups der VMs und die Datenbank von OpenNebula zugleich weg. Die VMs auf den Knoten liefen weiter, liessen sich aber nicht mehr verwalten. Ein günstiger Weg ist eine verschlüsselte Kopie des Backup-Datastores und der Ordner ~/backup und ~/platform, jede Nacht auf einen Speicher ausser Haus. Das kann eine Disk an einem zweiten Standort sein oder ein Objektspeicher in der Schweiz. Der Schlüssel dafür gehört nicht auf denselben Speicher.
Texte und Abbildungen stehen unter CC BY-SA 4.0 und der Code unter der MIT-Lizenz. Die Quellen liegen auf GitHub.