Logs mit Loki
Auftrag
«Am Samstag hatten drei Kundinnen beim Bezahlen eine Fehlermeldung», schreibt das Veloatelier Matte. «Könnt ihr herausfinden, was da los war?»
Lernziele
Nach diesem Kapitel kannst du:
- Erklären, was Logs zeigen, das Metriken nicht zeigen
- Den Aufbau von Loki und Alloy im Cluster beschreiben
- Logs mit LogQL nach Namespace, Pod und Text filtern und zählen
- Den Fehler eines Deployments in den Logs finden
Logs und Metriken
Abschnitt betitelt „Logs und Metriken“Metriken sind Zahlen in festen Abständen. Sie zeigen, dass 5 % der Anfragen scheitern, aber nicht, welche und mit welcher Meldung. Logs sind Textzeilen, die ein Programm bei einem Ereignis schreibt. Sie enthalten die Einzelheiten, kosten aber mehr Speicher. In Kubernetes schreibt jeder Container seine Logs nach Standardausgabe und Standardfehler, der Node legt sie als Dateien ab. kubectl logs liest diese Dateien, aber nur, solange der Pod existiert. Wird er ersetzt, sind seine Logs weg.
Loki und Alloy
Abschnitt betitelt „Loki und Alloy“Loki sammelt Logs zentral und behält sie über das Ende eines Pods hinaus. Eine Volltextsuche indexiert den ganzen Text. Loki legt einen Index nur über wenige Labels wie Namespace und Pod an und durchsucht den Text erst bei der Abfrage. Das hält Loki klein. Dafür grenzt du jede Suche zuerst mit Labels ein.
Alloy von Grafana läuft als DaemonSet, also mit einem Pod pro Node. Jeder davon liest die Logs der Pods auf seinem Node, versieht sie mit Labels und schickt sie an Loki. Beide kamen mit dem Kopieren in Kapitel 5.1 in dein Repo, als zwei Applications in apps/loki.yaml. Die Anleitung von Alloy 1.21 für Kubernetes installiert dasselbe Chart mit Helm.
# Values of the chart loki for the lab, chapter 5.2. One process with its data on the disk of a nodedeploymentMode: SingleBinary
loki:  auth_enabled: false  commonConfig:    replication_factor: 1  storage:    type: filesystem  schemaConfig:    configs:      - from: "2026-01-01"        store: tsdb        object_store: filesystem        schema: v13        index:          prefix: index_          period: 24h  # Logs older than three days are deleted  limits_config:    retention_period: 72h  compactor:    retention_enabled: true    delete_request_store: filesystem
singleBinary:  replicas: 1  persistence:    size: 5Gi  resources:    requests:      cpu: 100m      memory: 256Mi
# The parts of a scalable installation stay offread:  replicas: 0write:  replicas: 0backend:  replicas: 0chunksCache:  enabled: falseresultsCache:  enabled: falsegateway:  enabled: falselokiCanary:  enabled: falsetest:  enabled: false
Loki läuft hier als ein einziger Prozess und speichert auf der Disk eines Nodes. Für ein Lab genügt das. Im Betrieb würde man Loki auf mehrere Prozesse verteilen und die Daten in einen Objektspeicher legen. Logs, die älter als drei Tage sind, löscht Loki. Den Modus SingleBinary beschreibt auch die Anleitung von Loki 3.6 zum monolithischen Chart, dort mit einem Objektspeicher.
# Values of the chart alloy for the lab, chapter 5.2. One Alloy per node reads the logs of its podsalloy:  configMap:    # Alloy expects one attribute per line, a block written on one line fails with "expected TERMINATOR"    content: |      discovery.kubernetes "pods" {        role = "pod"        selectors {          role  = "pod"          field = "spec.nodeName=" + sys.env("NODE_NAME")        }      }
      discovery.relabel "pods" {        targets = discovery.kubernetes.pods.targets        rule {          source_labels = ["__meta_kubernetes_namespace"]          target_label  = "namespace"        }        rule {          source_labels = ["__meta_kubernetes_pod_name"]          target_label  = "pod"        }        rule {          source_labels = ["__meta_kubernetes_pod_container_name"]          target_label  = "container"        }        rule {          source_labels = ["__meta_kubernetes_pod_label_app"]          target_label  = "app"        }      }
      loki.source.kubernetes "pods" {        targets    = discovery.relabel.pods.output        forward_to = [loki.write.default.receiver]      }
      loki.write "default" {        endpoint {          url = "http://loki.monitoring.svc:3100/loki/api/v1/push"        }      }  # Every Alloy only reads the pods of its own node  extraEnv:    - name: NODE_NAME      valueFrom:        fieldRef:          fieldPath: spec.nodeName  resources:    requests:      cpu: 20m      memory: 64Micontroller:  type: daemonset
Die Konfiguration von Alloy ist eine Kette aus vier Komponenten. discovery.kubernetes findet die Pods des eigenen Nodes. discovery.relabel macht aus Angaben von Kubernetes die Labels namespace, pod, container sowie app. loki.source.kubernetes liest die Logs, loki.write schickt sie an Loki. Weitere Beispiele mit diesen Komponenten stehen in der Anleitung von Alloy 1.21 für Logs aus Kubernetes. Im Testaufbau scheiterte eine Konfiguration, in der ein Block auf einer Zeile stand, mit «expected TERMINATOR». Alloy verlangt jedes Attribut auf einer eigenen Zeile.
Im Lab waren Loki und Alloy gut zwei Minuten nach dem Push bereit. Argo CD hatte ihre Applications gut 40 Sekunden vorher angelegt.
kubectl -n monitoring get pods -o wide | grep -E 'loki|alloy'Abfragen schreibst du in Grafana unter «Explore» mit der Datenquelle Loki. Eine Abfrage beginnt immer mit einer Auswahl von Streams in geschweiften Klammern.
| Abfrage | Ergebnis |
|---|---|
{namespace="velo"} | alle Logs des Veloateliers |
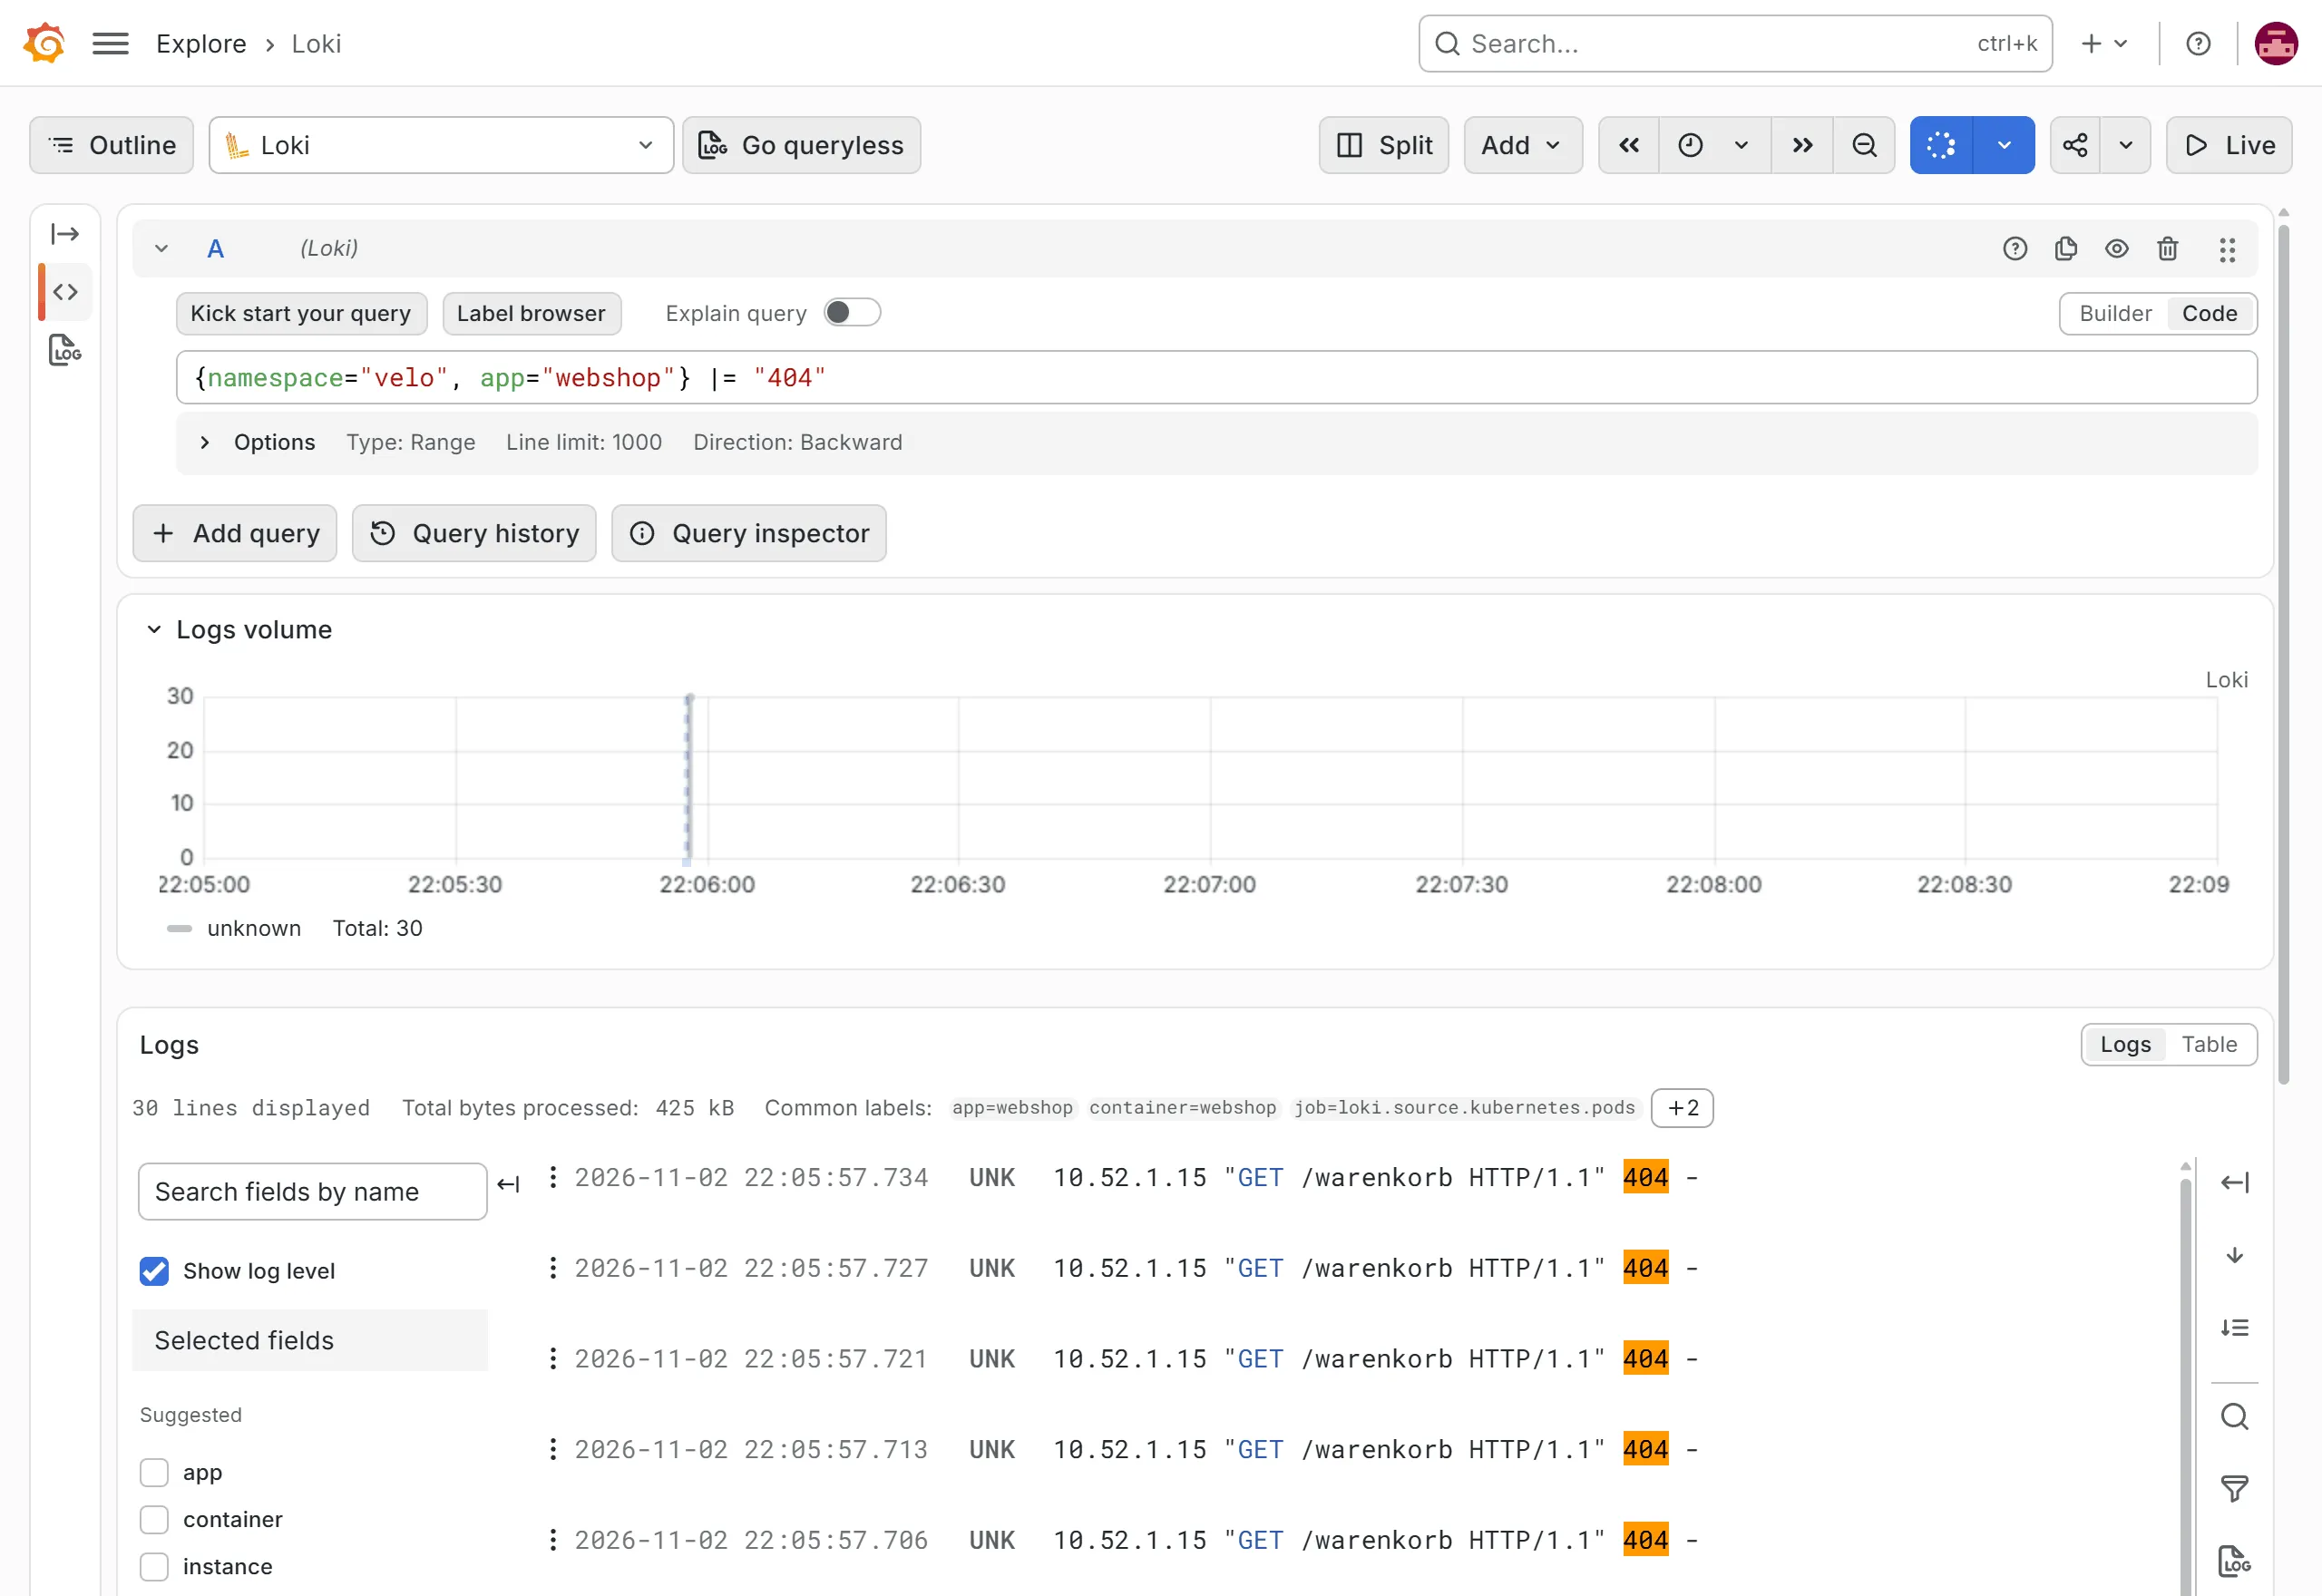
{namespace="velo", app="webshop"} |= "404" | Zeilen des Webshops, die 404 enthalten |
{namespace="velo"} |~ "(?i)error|exception" | Zeilen, auf die der reguläre Ausdruck passt |
{namespace="velo"} != "/healthz" | alles ausser den Proben von Kubernetes |
sum by (pod) (count_over_time({namespace="velo"} |= " 404 " [5m])) | Zahl der Zeilen mit 404 pro Pod in fünf Minuten |
|= filtert nach Text, |~ nach einem regulären Ausdruck, != schliesst Zeilen mit dem Text aus. count_over_time zählt die Zeilen in einem Zeitfenster und macht aus Logs eine Metrik, die du in Dashboards und Alerts verwenden kannst.
Im Lab erzeugten 20 Aufrufe einer Seite, die es nicht gibt, Zeilen mit 404.
for i in $(seq 20); do curl -s -o /dev/null http://<adresse-des-servers>/warenkorb; done10.52.1.10 "GET /warenkorb HTTP/1.1" 404 -Traefik verteilt die Anfragen auf die Pods. Die Abfrage mit count_over_time zeigte danach, wie viele dieser Aufrufe jeder Pod beantwortet hatte.
In Grafana stellst du die Abfrage unter «Explore» mit der Datenquelle Loki.
Labels mit Mass
Abschnitt betitelt „Labels mit Mass“Jede Kombination von Labels ist in Loki ein eigener Stream. Labels wie Namespace, Pod oder App haben wenige Werte und eignen sich gut. Eine IP-Adresse, eine Bestellnummer oder ein Pfad als Label würden Tausende Streams erzeugen und Loki langsam machen. Was sich oft ändert, bleibt im Text und wird mit |= gesucht.
Aufgabe Lab
Rolle Loki und Alloy aus, erzeuge Aufrufe mit 404 und finde sie in Grafana. Zähle sie pro Pod.
Lösung
{namespace="velo", app="webshop"} |= "404" zeigt die Zeilen mit /warenkorb, das Label pod sagt, welcher Pod geantwortet hat. sum by (pod) (count_over_time({namespace="velo"} |= " 404 " [5m])) zeigt eine Zahl pro Pod, zusammen etwa 20.
Aufgabe Fehler finden
Spiele zuerst den Fehler nach, als wärst du jemand anderes aus dem Team. Der Befehl setzt im Deployment des Webshops die Variable FAIL_PERCENT auf 30. Danach antwortet der Shop auf drei von zehn Anfragen mit einem Fehler.
cd ~/platformsed -i '/FAIL_PERCENT/{n;s/value: "0"/value: "30"/}' webshop/deployment.yamlgit commit -am "Webshop anpassen"git pushRufe den Shop einige Male auf, sobald Argo CD die Änderung übernommen hat. Finde in den Logs heraus, was die Kundschaft erlebt. Suche danach im Git-Verlauf, wer es war. Stelle zum Schluss den alten Stand her.
Lösung
{namespace="velo", app="webshop"} |= "error" zeigt Zeilen wie error: simulated failure on /, daneben Zeilen mit dem Status 500. git log -p webshop/deployment.yaml zeigt den Commit mit Autor und Änderung, seine Zeit passt zur ersten Fehlerzeile. git revert und git push stellen den alten Stand her, Argo CD rollt ihn aus.
Aufgabe Ein Label zu viel
Ein Kollege schlägt vor, in Alloy die IP-Adresse der Kundschaft als Label zu setzen, damit man schneller nach einer Kundin suchen kann. Was antwortest du?
Lösung
Jede Adresse wäre ein eigener Stream, bei vielen Kundinnen und Kunden Tausende. Loki würde langsamer und bräuchte mehr Speicher. Was sich oft ändert, gehört in den Text und wird mit |= gesucht. Im Lab steht dort allerdings nur die Adresse von Traefik, etwa 10.52.1.10. Der Webshop sieht die Verbindung von Traefik und nicht die der Kundschaft. Dazu kommt der Datenschutz. Eine IP-Adresse ist ein Personendatum. Wer sie speichert, braucht dafür einen Zweck und eine Aufbewahrungsfrist.
Texte und Abbildungen stehen unter CC BY-SA 4.0 und der Code unter der MIT-Lizenz. Die Quellen liegen auf GitHub.